Equipo de TI evaluando la redundancia de conectividad empresarial

Redundancia de conectividad: evitar un respaldo aparente

Contratar dos enlaces de Internet no garantiza una redundancia de conectividad real. Ambos pueden entrar al edificio por el mismo ducto, depender de una infraestructura común o terminar en un único equipo sin respaldo eléctrico. En ese escenario, la empresa paga dos contratos, pero conserva un solo punto de falla.

La pregunta útil no es cuántos proveedores aparecen en la factura, sino qué interrupciones puede resistir la arquitectura y durante cuánto tiempo. Resolverla exige relacionar la conectividad con los procesos que dependen de ella: ventas, telefonía, acceso a servicios en la nube, operación de sucursales, videovigilancia o trabajo remoto.

Cuándo la redundancia de conectividad es solo aparente

Un enlace secundario aporta continuidad cuando reduce la probabilidad de fallar por la misma causa que el principal. La independencia comercial ayuda, pero no basta. Dos operadores pueden compartir fibra mayorista, cámaras subterráneas, postes, nodos de agregación o una misma acometida al edificio. Un corte físico o una falla aguas arriba podría afectar a ambos al mismo tiempo.

También existen dependencias dentro de la empresa. Si los dos enlaces llegan al mismo router, usan una sola fuente eléctrica o requieren una configuración manual que nadie ha probado, el punto débil se trasladó desde el proveedor hacia la instalación local. Lo mismo ocurre cuando el respaldo conserva Internet, pero no permite resolver nombres, autenticar usuarios, establecer la VPN o acceder a las aplicaciones necesarias.

NIST recomienda que los servicios alternativos de telecomunicaciones reduzcan la posibilidad de compartir puntos únicos de falla y, cuando el riesgo lo justifique, estén separados de los servicios principales frente a amenazas comunes. Ese principio convierte la diversidad física y lógica en un requisito verificable, no en una etiqueta comercial.

Diseñar el respaldo desde el impacto operacional

No todas las sedes ni aplicaciones necesitan la misma disponibilidad. Una oficina puede operar temporalmente con acceso limitado, mientras una sucursal que procesa pagos o un recinto que transmite videovigilancia puede requerir continuidad inmediata. Por eso conviene comenzar por los procesos críticos y los objetivos de recuperación, no por la velocidad ofrecida por el segundo enlace.

Los objetivos RTO y RPO ayudan a expresar cuánto tiempo puede permanecer interrumpido un servicio y cuánta información puede perderse. En conectividad, esa definición permite decidir si basta una conmutación manual, si se necesita failover automático o si algunos servicios deben conservar prioridad cuando el enlace alternativo tiene menor capacidad.

Antes de considerar resuelto el riesgo, la organización debería poder demostrar al menos:

  • qué procesos, sedes y servicios dependen de cada conexión;
  • si las rutas físicas y los proveedores comparten infraestructura crítica;
  • qué equipos, energía, DNS, autenticación y seguridad intervienen en la conmutación;
  • qué nivel de operación degradada puede sostener el enlace alternativo;
  • quién decide, ejecuta y verifica el retorno al servicio normal.
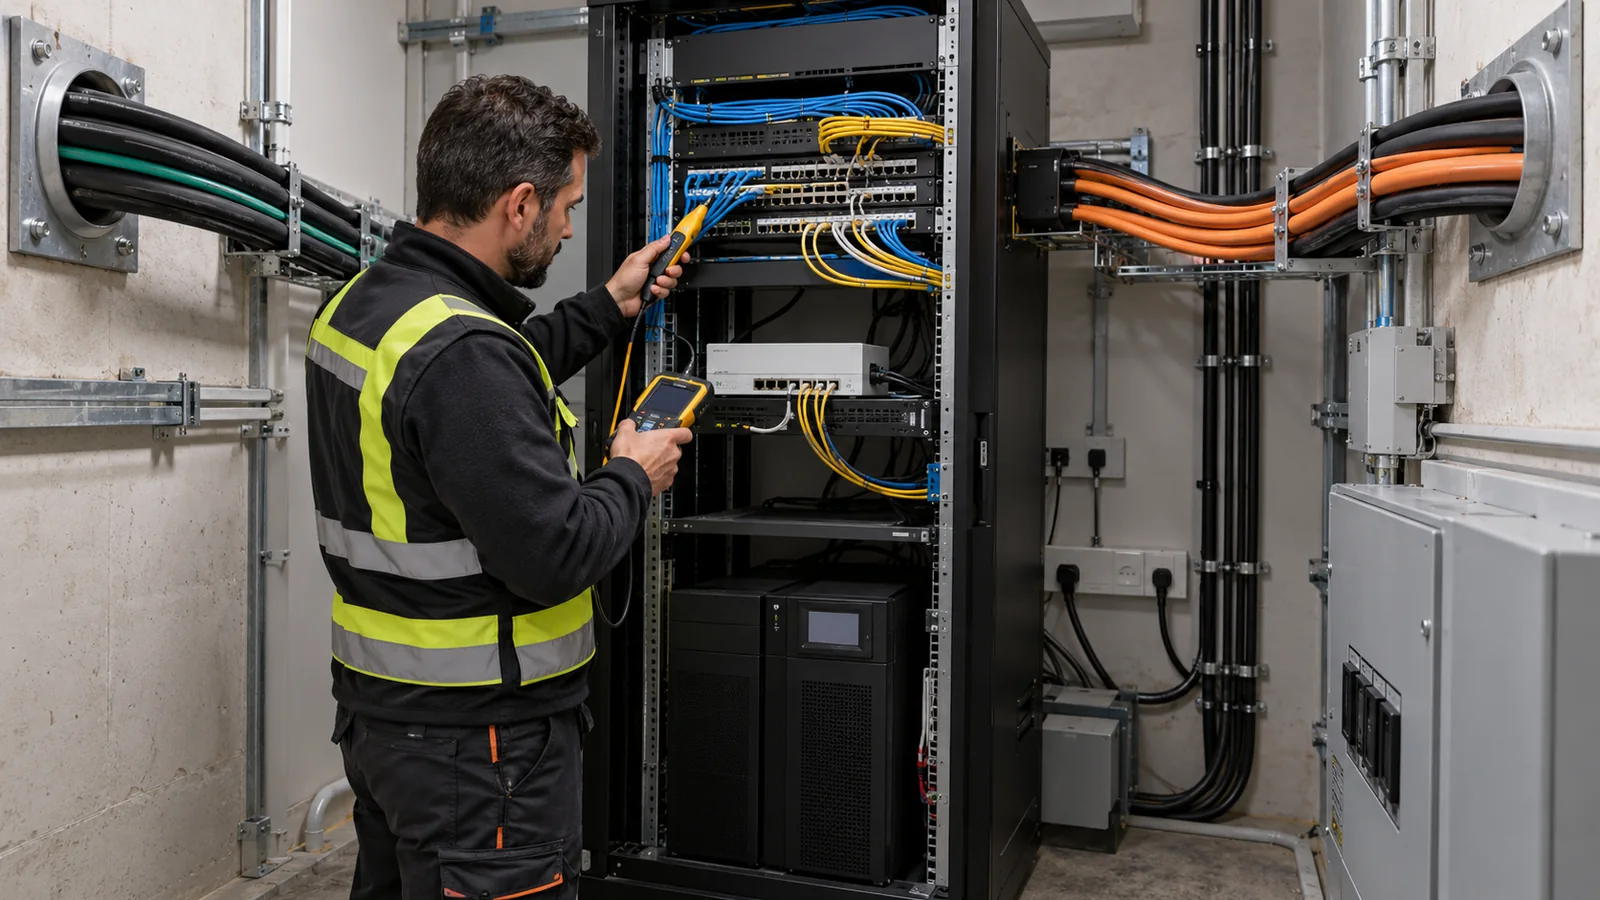
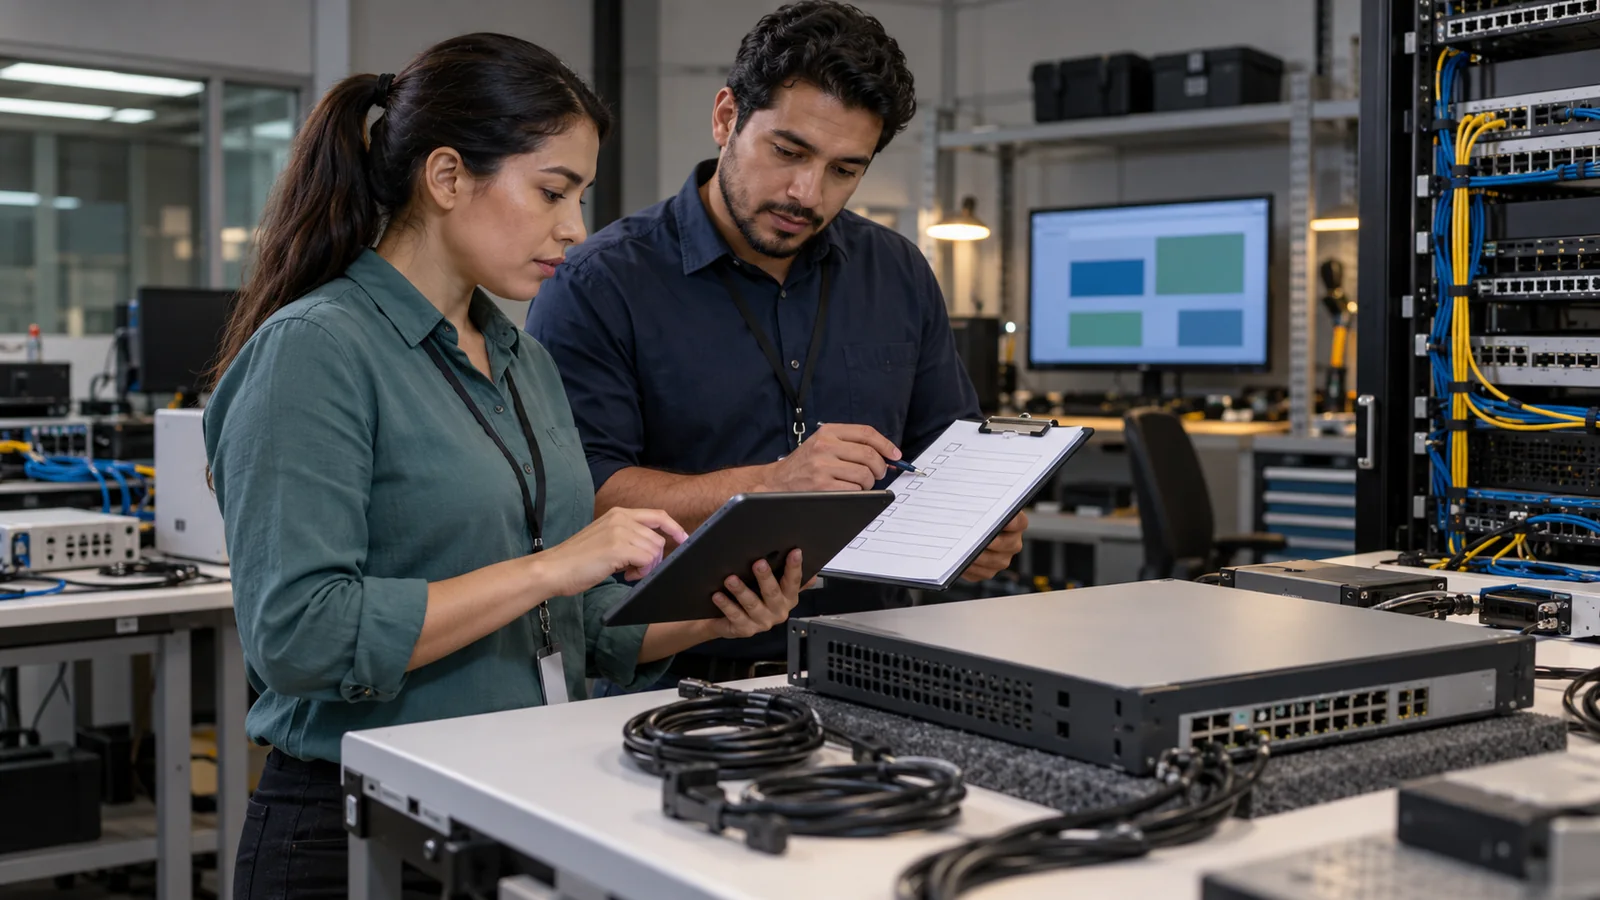
Técnico revisando rutas físicas para la redundancia de conectividad empresarial
La diversidad de rutas, equipos y energía debe comprobarse en la instalación, no presumirse a partir de los contratos.

El failover debe probarse en condiciones controladas

Una configuración de respaldo puede permanecer meses sin utilizarse y fallar justo cuando se necesita. Las rutas cambian, los equipos reciben actualizaciones, aparecen nuevas aplicaciones y se agregan reglas de seguridad. Por eso una prueba no debe limitarse a confirmar que un computador abre una página web.

La validación necesita observar la continuidad de los servicios relevantes, el tiempo real de conmutación, las sesiones que se interrumpen, la capacidad disponible y la generación de alertas. También debe comprobar el retorno al enlace principal. Un mecanismo que recupera conectividad pero deja rutas asimétricas, registros incompletos o sesiones inestables todavía representa un riesgo operacional.

El resultado útil es evidencia: fecha, alcance, comportamiento observado, limitaciones y acciones correctivas. Esa información permite distinguir entre una capacidad demostrada y una expectativa basada en el diseño. Además, entrega a gerencia un criterio para decidir si el nivel de continuidad obtenido corresponde al impacto que se busca reducir.

La disponibilidad no debe debilitar la seguridad

La salida alternativa necesita mantener controles equivalentes. No debería convertirse en un camino con reglas más permisivas, administración expuesta o menor trazabilidad. El control 12 de CIS incluye disponibilidad dentro de una arquitectura de red segura y exige gestionar activamente los dispositivos, configuraciones y documentación de la infraestructura.

Esta revisión se relaciona con el inventario de activos tecnológicos y con la segmentación de red empresarial. Si no se conocen los equipos, enlaces y dependencias, resulta difícil mantener el respaldo o evitar que una conmutación altere los límites de seguridad previstos.

Convertir dos enlaces en una capacidad de continuidad

La redundancia de conectividad se demuestra cuando la empresa conoce sus dependencias, ha reducido las fallas comunes y puede verificar la conmutación sin perder controles esenciales. La velocidad del enlace alternativo importa, pero después de confirmar ruta, energía, equipos, configuración, monitoreo y responsabilidades.

La División de Redes y Sistemas de AllDefense puede apoyar el levantamiento de la arquitectura, sus puntos de falla y los criterios técnicos para una conectividad más resiliente. El objetivo es que el respaldo exista en la operación y no solo en el contrato.

Fuentes consultadas

Personas, jefatura y TI coordinan la baja de un usuario y sus accesos

Baja de usuarios: revocar accesos sin dejar cuentas huérfanas

La baja de un usuario no termina cuando Recursos Humanos registra la salida. Una misma persona puede conservar correo, VPN, aplicaciones SaaS, repositorios, accesos a clientes, tokens, credenciales locales y cuentas administradas por proveedores distintos. Si la empresa revoca solo el directorio principal, deja abiertas rutas que ya no tienen una necesidad laboral.

El objetivo tampoco es desconfiar de quien se retira. Es ejecutar una decisión de negocio de forma completa, oportuna y demostrable. El proceso debe conectar la salida o cambio de función con cada identidad, privilegio, equipo y secreto que la persona utilizaba. Así se protege a la empresa y se evita que una cuenta huérfana termine en manos de terceros.

La baja de usuarios comienza antes del último día

Recursos Humanos conoce la fecha y condición de la salida; la jefatura sabe qué funciones deben transferirse; TI administra parte de las cuentas; y los dueños de aplicaciones autorizan accesos específicos. Si la notificación aparece solo como un ticket genérico al final de la jornada, cada área interpreta el alcance y los tiempos por separado.

Conviene definir un evento formal que active el flujo, con fecha efectiva, responsable y tratamiento según riesgo. Una salida planificada permite inventariar accesos y transferir información. Una desvinculación inmediata puede exigir revocar sesiones y credenciales en un momento acordado, antes de recuperar el equipo. La urgencia no elimina la coordinación: hace más importante que el orden esté decidido de antemano.

Qué accesos deben entrar en el alcance

La cuenta corporativa es solo el punto de partida. El inventario debe considerar identidades en aplicaciones de negocio, nubes, VPN, repositorios, plataformas de proveedores, herramientas de colaboración, accesos físicos y cuentas locales. También debe incluir llaves de API, certificados, tokens y secretos compartidos que podrían seguir funcionando aunque la cuenta personal quede deshabilitada.

Por eso, la baja depende de un inventario de activos tecnológicos y de dueños de aplicación identificados. Si nadie puede relacionar a una persona con los sistemas que usa, el equipo de TI buscará a ciegas. Centralizar identidades mediante un directorio o inicio de sesión único reduce dispersión, pero no reemplaza el control de aplicaciones que quedan fuera de esa integración.

Equipo técnico verifica la revocación de accesos en distintas aplicaciones
La verificación debe contrastar la persona, sus cuentas y el estado real de cada acceso. Ilustración editorial generada con IA.

Deshabilitar primero, eliminar después

CIS Control 6.2 propone revocar el acceso mediante la deshabilitación inmediata de cuentas ante una terminación, pérdida de derechos o cambio de rol. Deshabilitar conserva trazabilidad y permite revisar acciones anteriores; eliminar de inmediato puede destruir relaciones necesarias para una auditoría o para recuperar información de negocio. La retención posterior debe responder a reglas definidas, no transformarse en una excusa para mantener la cuenta activa.

La revocación debe abarcar sesiones vigentes, factores de autenticación, contraseñas de aplicación, certificados y tokens. Cuando existan secretos compartidos, la salida exige rotarlos y comprobar qué integraciones dependen de ellos. Para cuentas con mayor impacto, la empresa puede incorporar una revisión específica de accesos privilegiados, credenciales de emergencia y cuentas técnicas conocidas por la persona.

Los cambios de rol crean el mismo riesgo

Mover a alguien de área suele parecer menos riesgoso que una salida, pero puede acumular permisos incompatibles. La persona recibe nuevos accesos y conserva los anteriores porque nadie define qué debe retirarse. NIST SP 800-53, en AC-2 Account Management, pide alinear la administración de cuentas con procesos de terminación y transferencia. El control se completa cuando el nuevo rol tiene solo lo necesario y los permisos anteriores dejan de estar activos.

Las revisiones periódicas ayudan a encontrar acumulaciones, aunque no sustituyen una baja a tiempo. NIST CSF 2.0 ubica la gestión de identidades y credenciales en PR.AA-01. CISA también recomienda conectar los sistemas de gobierno de identidades con los procesos de personal para automatizar la deshabilitación y mantener un registro de cuentas y privilegios asociados a cada individuo.

Qué evidencia demuestra que la revocación funcionó

Un ticket cerrado no prueba que todos los accesos hayan desaparecido. La evidencia puede incluir la identidad de la persona, fecha efectiva, sistemas revisados, hora de deshabilitación, sesiones revocadas, activos recuperados, secretos rotados, excepciones y validación del dueño. Una muestra de bajas recientes permite comparar la lista esperada con el estado real de las cuentas.

La medición debe centrarse en brechas útiles: cuentas aún activas después de la salida, aplicaciones sin responsable, revocaciones fuera de plazo y excepciones sin vencimiento. Una Auditoría de Seguridad de AllDefense puede revisar el flujo completo, desde el evento de personal hasta la evidencia técnica, para identificar dónde se pierde el alcance sin inventar una cobertura que la organización no posee.

Una baja confiable no depende de recordar todas las cuentas el último día. Depende de un proceso compartido entre personas, jefaturas, TI y dueños de sistemas, con inventario, tiempos y comprobación. Ese diseño también mejora altas y cambios de rol: cada acceso nace con un responsable y puede retirarse cuando deja de existir su justificación.

Fuentes consultadas

Equipo de construcción revisa riesgos de continuidad y ciberseguridad

LD Constructora figura en una reivindicación atribuida a Qilin

LD Constructora figura en una reivindicación atribuida a Qilin que ransomware.live incorporó el 10 de octubre de 2026. La plataforma registra la detección a las 12:45 UTC y muestra el mismo día como fecha estimada del ataque. Esa referencia es una estimación del servicio de seguimiento: no confirma cuándo habría comenzado un incidente ni acredita por sí sola una intrusión.

El registro remite al dominio ldconstructora.cl. En su sitio oficial, LD Constructora se presenta como una empresa chilena con más de 30 años de trayectoria, oficinas en Santiago y Coyhaique y experiencia en obras clínicas, hospitalarias, educacionales, habitacionales e industriales. Esa información permite verificar la organización y su vínculo con Chile, pero no demuestra que sus sistemas o proyectos hayan sido afectados.

Qué se conoce y qué falta por confirmar

La ficha pública no describe el vector de acceso, los sistemas presuntamente comprometidos, una eventual extracción de datos ni consecuencias operacionales. Al momento de esta revisión no encontramos una confirmación pública de LD Constructora, ANCI o CSIRT de Gobierno que corroborara la afirmación. Tampoco hay evidencia pública suficiente para asociar la fecha estimada con acceso inicial, cifrado o publicación por parte del actor.

Por eso, el dato responsable es que el nombre de la empresa aparece en un registro de reivindicaciones. No corresponde concluir que una obra se detuvo, que información fue robada o que existió un impacto sobre clientes, trabajadores o proveedores. Para empresas chilenas del sector, el caso sí recuerda la importancia de conocer dependencias entre oficinas, obras, plataformas de proveedores, identidades y servicios de respaldo, sin atribuir esas condiciones a LD Constructora.

Especialistas validan recuperación y segmentación en una operación de construcción
Ilustración editorial referencial generada con IA. No corresponde a LD Constructora ni representa un incidente real.

Qilin: software, operación y afiliados no son lo mismo

MITRE ATT&CK identifica Qilin como el software S1242: una familia de ransomware ofrecida bajo un modelo de ransomware como servicio, activa al menos desde 2022 y con variantes para Windows, Linux y VMware ESXi. MITRE asocia la operación de Qilin con Water Galura (G1050) y documenta que otros actores también han usado el software. En un esquema RaaS, operador, afiliado y malware son componentes diferentes; una reivindicación atribuida a Qilin no identifica necesariamente a la persona o afiliado que habría actuado.

El perfil histórico de S1242 incluye T1190: Exploit Public-Facing Application, T1486: Data Encrypted for Impact y T1490: Inhibit System Recovery. Estas técnicas describen comportamientos observados previamente en operaciones de Qilin. No hay evidencia pública que permita afirmar que alguna de ellas haya sido utilizada en el registro relativo a LD Constructora.

Controles vinculados con las técnicas documentadas

Para T1190, MITRE relaciona M1051: Update Software y M1016: Vulnerability Scanning. En la práctica, una empresa debe mantener un inventario de servicios expuestos, aplicar actualizaciones según riesgo y comprobar que los hallazgos realmente se cerraron. Una evaluación de amenazas ayuda a priorizar escenarios relevantes, mientras la gestión de vulnerabilidades conecta la detección con responsables y evidencia de corrección.

Para T1486 y T1490, M1053: Data Backup recomienda copias periódicas almacenadas fuera del sistema y protegidas contra su destrucción. La medida solo es confiable si existen restauraciones probadas, credenciales separadas y una copia que no pueda modificarse desde el entorno cotidiano. La guía de AllDefense sobre copias de seguridad contra ransomware desarrolla cómo convertir el respaldo en capacidad de recuperación.

Sin telemetría del caso, estas son medidas preventivas basadas en el comportamiento histórico documentado, no una reconstrucción del supuesto incidente. Una Auditoría de Seguridad puede revisar exposición, accesos, segmentación y recuperación con evidencia propia de la organización. Mientras no exista información oficial adicional, la comunicación debe conservar la diferencia entre una reivindicación pública y un hecho técnicamente confirmado.

Fuentes consultadas

Equipo revisa un inventario de activos tecnológicos para asignar responsables

Inventario de activos tecnológicos: saber qué proteger

Un inventario de activos tecnológicos puede existir y seguir siendo inútil para seguridad. La planilla registra equipos comprados, pero deja fuera máquinas virtuales, servicios en la nube, aplicaciones contratadas por un área o componentes que permanecen conectados después de un proyecto. Ante una vulnerabilidad o un incidente, la empresa conoce el nombre del activo, pero no su función, responsable ni importancia para la operación.

El propósito no es contar equipos. Un inventario confiable debe permitir responder qué existe, quién lo administra, para qué proceso se utiliza, qué dependencias mantiene y cuál es su estado durante el ciclo de vida. Esa información convierte un listado administrativo en una base para decidir sobre exposición, acceso, soporte, continuidad y riesgo.

Qué debe incluir un inventario de activos tecnológicos

NIST CSF 2.0 ubica la gestión de activos en la función Identificar. Sus resultados ID.AM-01 e ID.AM-02 consideran inventarios de hardware, software, servicios y sistemas; también incorporan proveedores, datos, flujos y prioridad según criticidad e impacto. Esto evita reducir el alcance a dispositivos físicos. Una aplicación SaaS, una API, un contenedor o un servicio administrado puede ser tan relevante como el servidor que la empresa ve en una sala técnica.

Para cada activo conviene registrar un identificador estable, tipo, ubicación, propietario de negocio, responsable técnico, servicio que soporta, autorización y etapa del ciclo de vida. En software importan la versión, el fabricante, el propósito y la condición de soporte. El control CM-8 de NIST SP 800-53 pide que el inventario refleje el sistema con el detalle necesario y evite contabilizaciones duplicadas.

Un activo sin responsable sigue fuera de control

Detectar un equipo o una aplicación no resuelve quién puede aceptar una interrupción, autorizar un cambio o decidir su retiro. El responsable técnico conoce la plataforma; el dueño de negocio entiende el proceso y las consecuencias. Ambos roles son necesarios. Si el inventario conserva solo una dirección IP o un nombre de host, seguridad terminará asignando prioridades sin comprender el impacto real.

La propiedad debe sobrevivir a los cambios organizacionales. Un proyecto puede cerrar o un área reorganizarse mientras el servicio continúa activo. Los registros sin dueño vigente se convierten en excepciones permanentes: nadie confirma si aún son necesarios ni incorpora su renovación, respaldo o retiro al presupuesto.

Por qué el inventario falla aunque la empresa use herramientas

Las fuentes observan realidades distintas. Compras sabe qué se adquirió; una herramienta de endpoints ve los equipos donde instaló su agente; la nube conoce recursos de una cuenta; redes detecta conexiones; finanzas identifica suscripciones. Ninguna vista aislada demuestra que el inventario esté completo. Tampoco basta unir exportaciones, porque pueden registrar el mismo activo con nombres diferentes o conservar elementos que ya fueron retirados.

El contraste con la superficie de ataque externa de la empresa permite descubrir dominios, servicios e interfaces ausentes del registro interno. La diferencia entre lo declarado y lo observado no se corrige solo agregando una fila: exige validar pertenencia, propósito, autorización y responsable.

Equipo contrasta fuentes para validar un inventario de activos tecnológicos
La confiabilidad surge al reconciliar registros administrativos, observación técnica y contexto del negocio. Ilustración editorial generada con IA.

Qué decisiones debe sostener el inventario

Un registro útil permite saber qué activos entran en un análisis, cuáles requieren actualización y dónde una falla afectaría un servicio relevante. También ayuda a verificar cobertura de monitoreo, respaldo, protección de endpoints y gestión de identidades. Cuando una tecnología queda sin soporte, la decisión de renovar, aislar o retirar necesita conocer sus dependencias y propietario, no solo la fecha anunciada por el fabricante.

La misma base mejora la priorización de vulnerabilidades. Un hallazgo crítico sobre un componente inexistente es ruido; uno moderado en un activo público y esencial puede requerir atención inmediata. Si el alcance nace de una lista incompleta, la evaluación también será incompleta.

Cómo comprobar si el inventario es confiable

La revisión debe buscar evidencia, no perfección declarada. Conviene comparar una muestra de activos observados con el registro autorizado, identificar elementos sin dueño, revisar duplicados y comprobar que altas, cambios y bajas dejan trazabilidad. También importa conocer la fecha de la última validación y qué entornos quedan fuera de las herramientas habituales, como dispositivos IoT, sedes remotas, cuentas cloud o servicios operados por terceros.

CIS Control 1 propone administrar los activos empresariales conectados de forma física, virtual, remota o en la nube, y abordar los no autorizados. CIS Control 2 extiende el criterio al software. La automatización ayuda a detectar cambios, pero el contexto empresarial sigue necesitando responsables, criterios de autorización y procesos que mantengan la información vigente.

Dar alcance real a una evaluación

Si la preocupación principal es conocer debilidades técnicas sobre activos confirmados, el servicio de Análisis de Vulnerabilidades de AllDefense permite evaluar un alcance acordado y ordenar los hallazgos relevantes. Si la brecha está en la propiedad, el ciclo de vida o la evidencia del proceso, una Auditoría de Seguridad puede revisar por qué el inventario no refleja la operación.

Antes de sumar otra plataforma, conviene comprobar si la empresa puede explicar qué protege y por qué. El resultado valioso no es una cifra total de activos, sino una base verificable que permita incluir lo desconocido, retirar lo innecesario y asignar decisiones a quienes realmente pueden tomarlas.

Fuentes consultadas

Equipo prioriza acciones dentro de un proceso de gestión de vulnerabilidades

Gestión de vulnerabilidades: decidir qué corregir primero

La gestión de vulnerabilidades se vuelve difícil cuando el informe crece más rápido que la capacidad de corregir. Una empresa puede recibir cientos de hallazgos, ordenarlos por severidad y seguir sin responder la pregunta que importa: cuál puede afectar primero un servicio relevante y quién debe resolverlo. Escanear con mayor frecuencia no corrige esa brecha. La prioridad necesita combinar evidencia técnica, contexto operativo y una decisión con responsable.

El objetivo tampoco es instalar todos los parches apenas aparecen. Algunos cambios requieren pruebas o coordinación con proveedores. Lo exigible es explicar por qué una vulnerabilidad quedó primero, qué acción se acordó y cómo se comprobará la reducción del riesgo.

La gestión de vulnerabilidades no puede depender solo de CVSS

CVSS permite comunicar características y severidad técnica con un método común. La especificación CVSS 4.0 de FIRST distingue métricas base, de amenaza y ambientales. El puntaje base representa cualidades intrínsecas; no conoce el servicio que sostiene el activo, su exposición ni el impacto particular para la empresa. Como única regla, puede postergar hallazgos con una ruta de explotación más directa.

La severidad sigue siendo útil, pero debe convivir con otras señales. El catálogo KEV de CISA identifica vulnerabilidades con evidencia de explotación conocida. EPSS, mantenido por FIRST, estima la probabilidad de que una CVE sea explotada en los próximos 30 días. KEV aporta evidencia observada; EPSS, probabilidad; CVSS, severidad. Ninguna fuente sabe si el activo está presente, alcanzable o vinculado con un proceso crítico de la organización.

Qué factores permiten decidir qué corregir primero

Una prioridad defendible comienza por validar producto, versión, configuración y alcance antes de movilizar una ventana urgente. Después conviene relacionar explotación conocida o probable, exposición, privilegios que habilitaría un abuso e impacto sobre el servicio, los datos y la continuidad.

Ese contexto cambia la lectura del reporte. Una vulnerabilidad media en una interfaz administrativa expuesta puede requerir más urgencia que una vulnerabilidad crítica presente en un componente deshabilitado. Del mismo modo, una falla en un servidor interno puede adquirir prioridad cuando forma parte de una cadena que conduce a identidades privilegiadas, respaldos o sistemas de producción. La superficie de ataque externa ayuda a reconocer activos públicos; la gestión de vulnerabilidades debe continuar el análisis y conectarlos con propietarios y consecuencias.

Equipo prioriza hallazgos dentro de un proceso de gestión de vulnerabilidades
La prioridad surge al relacionar evidencia técnica, exposición y consecuencias para el servicio.

Convertir hallazgos en una cola que pueda gestionarse

El reporte técnico debe transformarse en trabajo asignado. Cada hallazgo necesita un activo confirmado, responsable, acción, plazo y evidencia de cierre. Las clases de atención pueden considerar criticidad y restricciones de cambio, pero no deberían convertirse en plazos universales. Las fechas obligatorias de CISA aplican a organismos federales civiles de Estados Unidos; para una empresa chilena, KEV funciona como señal dentro de su propio criterio de riesgo.

También debe existir una ruta cuando el parche no es viable. Segmentar, restringir acceso o deshabilitar una función puede reducir exposición mientras se prepara una solución definitiva. La excepción requiere dueño, justificación, control compensatorio y vencimiento. Si el activo está sin soporte, la decisión se acerca más a renovar, aislar o retirar que a prolongar el mismo ticket.

NIST trata el parcheo empresarial como mantenimiento preventivo. La SP 800-40 Rev. 4 incluye identificar, priorizar, instalar y verificar actualizaciones, bajo una estrategia acordada entre negocio y tecnología. Así se evita que seguridad entregue listas mientras operaciones asume sola el riesgo del cambio.

Cómo verificar que una vulnerabilidad realmente quedó cerrada

Cerrar no significa marcar el ticket como resuelto. La evidencia puede incluir versión instalada, configuración aplicada, nueva validación y comprobación del servicio. Una medida compensatoria debe verificarse desde la ruta que pretendía limitar. El reescaneo aporta evidencia, pero no demuestra por sí solo que todas las instancias recibieron la corrección.

Si el mismo hallazgo reaparece, el problema puede estar en el inventario, el despliegue, las imágenes base o la gestión de proveedores. Medir solo cuántas vulnerabilidades se cerraron premia el volumen. Resulta más útil observar exposición vencida, tiempo hasta validar, excepciones fuera de plazo, cobertura y reincidencia en servicios críticos.

Cuándo conviene una evaluación independiente

Una empresa puede necesitar apoyo externo cuando desconoce la cobertura de sus herramientas, acumula falsos positivos o no logra vincular hallazgos con activos. Antes de encargar pruebas, conviene distinguir el propósito mediante la comparación entre auditoría de seguridad y análisis de vulnerabilidades.

El servicio de Evaluación de Amenazas de AllDefense puede aportar una revisión focalizada de exposición y vulnerabilidades para convertir evidencia técnica en prioridades comprensibles. Si el problema está en el proceso, la trazabilidad o el cumplimiento de controles, una auditoría de seguridad permite evaluar por qué los hallazgos no se corrigen o vuelven a aparecer. La decisión útil no es producir otro listado: es establecer qué riesgo reducir, quién actuará y qué evidencia demostrará el resultado.

Fuentes consultadas

Ilustración referencial de profesionales revisando riesgos digitales en una operación de distribución de climatización; no muestra a ANWO ni un incidente real

ANWO figura en una reivindicación atribuida a SafePay

ANWO figura en una reivindicación atribuida a SafePay que ransomware.live incorporó el 5 de octubre de 2026. El servicio indica que detectó la publicación a las 18:28 UTC y muestra ese mismo día como fecha estimada del ataque. Esta última referencia es una estimación de la plataforma, no una fecha confirmada por la organización.

La ficha identifica el dominio anwo.cl. El sitio oficial de ANWO señala que la empresa fue creada en 1984, distribuye equipos de climatización en Chile y mantiene sucursales en distintas regiones. Esa información acredita el vínculo con el país, pero no confirma una intrusión. Al momento de esta revisión no encontramos un comunicado público de ANWO, ANCI o CSIRT de Gobierno que corroborara acceso no autorizado, cifrado, extracción de información o impacto operacional. Por eso, el registro debe tratarse como una afirmación del actor y no como prueba independiente del incidente.

Qué afirma el registro y qué falta por confirmar

Ransomware.live atribuye la reivindicación a SafePay, sin describir en la ficha el vector de entrada, los sistemas presuntamente afectados ni evidencias técnicas verificables. Tampoco permite establecer si la fecha estimada corresponde al acceso inicial, a una eventual acción sobre sistemas o simplemente al momento en que el actor decidió publicar el nombre. Quedan por confirmar el alcance, la existencia de datos comprometidos, la continuidad de los servicios y cualquier medida de respuesta adoptada.

Para empresas chilenas, la relevancia preventiva está en la combinación de operaciones distribuidas, inventario, accesos remotos y sistemas de gestión que suele existir en compañías de distribución. Esto no implica que esos componentes hayan sido afectados en este caso. Sí justifica revisar dependencias críticas, cuentas con privilegios y capacidad de recuperación, especialmente cuando una operación necesita coordinar bodegas, sucursales y atención a clientes.

Ilustración referencial de monitoreo de endpoints y copias de seguridad aisladas en una operación de distribución
Ilustración editorial generada con IA, de carácter referencial. No muestra a ANWO ni un incidente real.

SafePay: comportamiento documentado, no evidencia del caso

MITRE ATT&CK no mantiene, a la fecha de revisión, un perfil verificable de grupo G ni de software S para SafePay. Por ello no corresponde asignarle un identificador, alias o relación con otro actor. Microsoft Security Intelligence describe SafePay como ransomware observado desde fines de 2024 y sin alias asociados. Según esa fuente, los actores detrás de la operación tienden a manejar internamente las etapas del ataque y emplean doble extorsión. Esa descripción histórica no permite afirmar que el mismo modelo, herramientas o conductas se hayan usado contra ANWO.

En muestras y operaciones analizadas por Microsoft, SafePay ha usado regsvr32.exe para cargar componentes, comportamiento que puede mapearse a T1218.010: Regsvr32. La misma fuente menciona Mimikatz para recolección de credenciales, compatible con T1003: OS Credential Dumping; cifrado de archivos, asociado a T1486: Data Encrypted for Impact; y eliminación de respaldos y puntos de restauración, alineada con T1490: Inhibit System Recovery. Son antecedentes del comportamiento habitual documentado, no técnicas observadas en esta reivindicación.

Controles prioritarios para reducir el riesgo

La primera medida es preservar evidencia y aislar equipos solo si existen señales reales de compromiso. Microsoft recomienda desconectar dispositivos afectados, cambiar credenciales y restaurar desde copias limpias. Para prevención, M1038: Execution Prevention respalda el control de aplicaciones: limitar binarios y scripts no requeridos y alertar sobre usos anómalos de herramientas legítimas como Regsvr32. No se trata de bloquear indiscriminadamente funciones de Windows, sino de definir dónde son necesarias y supervisar excepciones.

Frente a la recolección de credenciales, M1043: Credential Access Protection recomienda protecciones como Credential Guard cuando la plataforma lo permita. Conviene complementarlo con mínimo privilegio, MFA para accesos remotos y una gestión formal de cuentas privilegiadas. Para cifrado y sabotaje de la recuperación, M1053: Data Backup exige respaldos regulares fuera del sistema y protegidos contra su destrucción. Las copias deben ser aisladas o inmutables y, sobre todo, probarse mediante restauraciones; la guía de copias de seguridad contra ransomware desarrolla ese enfoque.

Sin telemetría del caso no es posible priorizar controles a partir de un vector confirmado. Una auditoría de seguridad orientada a accesos, endpoints y recuperación puede ayudar a revisar brechas concretas sin asumir que esta reivindicación describe lo ocurrido. Hasta que exista información oficial, la comunicación responsable consiste en separar el registro público de los hechos técnicamente comprobados.

Fuentes consultadas

Equipo define requisitos de seguridad al inicio de un proyecto tecnológico

Seguridad por diseño en proyectos tecnológicos

La seguridad por diseño en proyectos tecnológicos consiste en tomar decisiones de protección antes de que una solución quede contratada, desarrollada o integrada. No es una revisión final para “aprobar seguridad”, sino una forma de definir desde el inicio qué datos utilizará el proyecto, qué dependencias creará, quién podrá administrarlo y qué evidencia permitirá aceptarlo.

Para una empresa chilena, este enfoque reduce una dificultad frecuente: descubrir controles ausentes cuando el presupuesto ya está comprometido, la fecha de salida es inamovible y corregir exige rediseñar. La conversación útil comienza cuando todavía existen alternativas.

La seguridad empieza con el propósito del proyecto

Antes de escoger controles, el equipo necesita entender el resultado de negocio. Conviene identificar qué proceso cambiará, qué información ingresará o generará la solución, con cuáles sistemas se conectará y qué impacto tendría una indisponibilidad, alteración o divulgación. La clasificación de la información ayuda a que estas respuestas modifiquen decisiones concretas sobre acceso, almacenamiento, intercambio y conservación.

NIST Cybersecurity Framework 2.0 sitúa el gobierno y la comprensión del riesgo antes de las actividades de protección. Aplicado a un proyecto, esto implica asignar responsables y criterios de aceptación, no delegar toda la seguridad al área técnica. El dueño del proceso aporta el impacto; Tecnología explica arquitectura y operación; Seguridad plantea escenarios y verificaciones; Compras y Legal convierten requisitos en compromisos cuando participa un proveedor.

Definir resultados, no una lista genérica

Un requisito como “cumplir buenas prácticas” es difícil de comprobar. Resulta más útil describir resultados observables: las cuentas administrativas están separadas de las cuentas de uso diario; los accesos se revocan al terminar una función; los registros permiten reconstruir acciones críticas; la información sensible viaja y se almacena protegida; una restauración puede ejecutarse dentro de los objetivos definidos.

Cada resultado debe tener un responsable, una evidencia y un momento de validación. Algunas verificaciones ocurren en el diseño, otras durante pruebas y otras al preparar la operación. Así, seguridad deja de ser una opinión tardía y se convierte en una condición trazable del proyecto.

Incorporar seguridad al trabajo del proyecto

NIST SP 800-218 propone integrar prácticas de desarrollo seguro al ciclo de vida, en lugar de tratarlas como una fase aislada. Aunque su foco es software, la lógica también ayuda a ordenar proyectos que configuran o adquieren tecnología: preparar a las personas y procesos, proteger los componentes, producir una solución con prácticas definidas y responder a vulnerabilidades.

Esto no exige transformar cada iniciativa en un programa documental. Un proyecto pequeño puede mantener un registro breve de decisiones, responsables y pruebas. Uno crítico puede requerir modelado de amenazas, revisión de arquitectura, análisis de componentes, pruebas especializadas y un plan formal de remediación. La profundidad cambia según exposición e impacto; el principio es que las decisiones no desaparezcan entre correos y reuniones.

Equipo realiza una revisión técnica antes de poner un sistema en producción
La aceptación debe comprobar requisitos y evidencia antes de habilitar la operación. Ilustración editorial generada con IA.

Comprar tecnología también requiere diseño

Cuando la solución es de un tercero, la empresa no diseña el producto, pero sí diseña su forma de selección, configuración, integración y uso. La guía de CISA para elegir tecnologías seguras y verificables recomienda que las organizaciones compradoras evalúen características de seguridad y la posibilidad de verificar su funcionamiento.

Importa conocer opciones de autenticación, registros disponibles, gestión de vulnerabilidades, actualizaciones, exportación de datos, subcontratistas y condiciones de salida. El artículo sobre evaluación del riesgo de proveedores tecnológicos desarrolla la supervisión durante la relación; en el proyecto, la tarea específica es convertir esas necesidades en criterios de selección y aceptación antes de depender de la solución.

Crear puertas de decisión verificables

Un proyecto debería detenerse en puntos breves y conocidos: aprobación del diseño, autorización para conectar datos reales, aceptación técnica y paso a producción. En cada puerta se revisan solo las evidencias necesarias para esa decisión. Los hallazgos deben quedar resueltos, compensados o aceptados por quien tenga autoridad, con plazo y responsable.

También se necesita un criterio para cambios. Una nueva integración, el uso de datos más sensibles o la exposición a internet puede invalidar la evaluación original. La trazabilidad permite reconocer cuándo volver a revisar, sin repetir todo el proceso ante ajustes menores.

Preparar la operación antes del lanzamiento

La salida a producción no termina el proyecto de seguridad. Deben quedar definidos el dueño del servicio, las rutas de escalamiento, el tratamiento de vulnerabilidades, las revisiones de acceso, los respaldos, los registros y las condiciones para retirar la solución. Un control que depende de una persona del equipo de implementación puede desaparecer cuando esa persona vuelve a sus funciones habituales.

La asesoría estratégica de ciberseguridad puede ayudar a integrar estos criterios con prioridades, gobierno y riesgo empresarial. Una auditoría de seguridad puede contrastar posteriormente si los requisitos, configuraciones y evidencias acordados siguen operando. El objetivo es simple: que una decisión temprana evite una corrección costosa y deje controles que puedan sostenerse después del proyecto.

Fuentes consultadas

Equipo evalúa el riesgo de proveedores tecnológicos y sus dependencias

Riesgo de proveedores tecnológicos: evaluar con evidencia

El riesgo de proveedores tecnológicos no desaparece al firmar un contrato o recibir un cuestionario de seguridad. Una empresa puede conservar la responsabilidad sobre sus procesos mientras pierde visibilidad sobre quién administra la plataforma, qué subcontratistas intervienen, dónde quedan sus datos o cuánto tardaría en recuperar el servicio. La evaluación sirve cuando esas respuestas cambian una decisión, no cuando solo completan un expediente.

Para gerencia, Compras, Tecnología y Seguridad, el desafío es proporcionalidad. No conviene exigir la misma evidencia a una herramienta auxiliar que a la plataforma que procesa ventas, identidades o información sensible.

El riesgo de proveedores tecnológicos nace de la dependencia

Antes de evaluar controles, la organización necesita entender la relación. Importa saber qué proceso sostiene el proveedor, qué información recibe, qué accesos mantiene, con cuáles sistemas se integra y qué ocurriría si deja de operar.

El artículo sobre gobierno de aplicaciones SaaS y Shadow IT aborda servicios adquiridos fuera del proceso formal. La gestión de proveedores tiene un alcance diferente: acompaña relaciones conocidas y aprobadas desde su selección hasta su término, incluso cuando el contrato y el área responsable están plenamente identificados.

Clasificar antes de enviar cuestionarios

La clasificación debería combinar sensibilidad y volumen de datos, privilegios, impacto de una interrupción, capacidad de reemplazo, concentración y dependencia de otros proveedores. CIS Control 15 propone inventariar y clasificar prestadores considerando, entre otros elementos, disponibilidad, regulación, riesgo inherente y riesgo mitigado.

La clasificación de la información aporta una parte de esta decisión, pero no la resuelve completa. Dos proveedores que tratan datos equivalentes pueden requerir niveles distintos de supervisión si uno opera una función reemplazable y el otro concentra una dependencia sin alternativa. La categoría asignada debe definir profundidad de la evaluación, responsables, frecuencia y condiciones que obligan a revisar nuevamente.

Pedir evidencia que corresponda al riesgo

Un cuestionario respondido por el propio proveedor permite conocer su postura declarada, pero no demuestra por sí solo que los controles funcionan. Según el alcance, la evidencia puede incluir informes independientes vigentes, resultados de pruebas, registros de revisiones de acceso, ejercicios de continuidad, tratamiento de hallazgos o confirmación de compromisos contractuales. Un certificado tampoco debe leerse fuera de contexto: interesa su alcance, período, exclusiones y relación con el servicio contratado.

NIST SP 800-161 Rev. 1, actualizada en 2024, integra la gestión del riesgo de la cadena de suministro con las actividades generales de riesgo y contempla productos y servicios durante su ciclo de vida. La consecuencia práctica es evitar una evaluación aislada de Compras. Tecnología conoce las dependencias, el área usuaria entiende el impacto, Legal delimita compromisos y Seguridad analiza si la evidencia responde al riesgo identificado.

Equipo verifica evidencia técnica de un proveedor tecnológico
La revisión debe relacionar evidencia, dependencias y capacidad real de recuperación. Ilustración editorial generada con IA.

El contrato necesita responsables y activadores

Cláusulas sobre notificación de incidentes, accesos, subcontratación, continuidad, devolución y eliminación de datos tienen valor cuando alguien sabe cuándo activarlas. Una obligación de informar “oportunamente” puede resultar insuficiente si la organización necesita escalar una interrupción en minutos. El contrato debe conectarse con responsables operativos, canales vigentes y decisiones que puedan ejecutarse bajo presión.

También conviene distinguir un compromiso del proveedor de una capacidad propia. La empresa puede exigir respaldos y, aun así, necesitar copias o alternativas bajo su control. Puede acordar eliminación de datos y requerir evidencia de cierre. Puede recibir un nivel de servicio y descubrir que este mide disponibilidad técnica, no la recuperación completa del proceso. La revisión debe identificar esas diferencias antes de que se conviertan en una disputa durante un incidente.

Supervisar cambios durante la relación

La aprobación inicial envejece. El proveedor puede incorporar subcontratistas, mover funciones, cambiar controles de acceso, modificar condiciones de soporte o sufrir eventos que alteren su riesgo. NIST CSF 2.0 ubica la cadena de suministro dentro de la función Gobernar y plantea integrar su gestión con el riesgo empresarial. Esto favorece una supervisión basada en cambios relevantes y criticidad, no una solicitud idéntica de documentos para todos cada año.

Las señales deben traducirse en acciones conocidas: pedir nueva evidencia, revisar el alcance, aplicar controles compensatorios, aceptar el riesgo con plazo o preparar una sustitución. Acumular alertas sin dueño no mejora la supervisión. Tampoco sirve registrar una excepción sin fecha, porque termina convirtiendo una debilidad temporal en la condición normal de la relación.

Planificar la salida antes de necesitarla

La salida forma parte del riesgo de proveedores tecnológicos. Antes de depender del servicio, conviene entender cómo exportar datos en un formato utilizable, revocar identidades e integraciones, recuperar configuraciones, transferir conocimiento y comprobar la eliminación. Si el reemplazo exige meses de trabajo o existe una dependencia técnica difícil de separar, ese costo debe ser visible en la decisión inicial y en los planes de continuidad.

Revisar el control, no solo el expediente

Un programa maduro puede explicar cuáles proveedores son críticos, por qué reciben un nivel determinado de revisión, qué evidencia respalda su aprobación y qué cambió desde la última evaluación. Una auditoría de seguridad puede contrastar el proceso declarado con contratos, muestras de proveedores, evidencias operativas y decisiones de riesgo. El objetivo no es producir más formularios, sino comprobar que las dependencias externas se gobiernan con criterios consistentes y verificables.

Fuentes consultadas

Equipo clasifica información empresarial según su sensibilidad

Clasificación de la información para decidir controles

Una carpeta marcada como “confidencial” no está mejor protegida si cualquier persona puede abrirla, copiarla o enviarla fuera de la empresa. La clasificación de la información sirve cuando la categoría cambia decisiones concretas. Si solo agrega una etiqueta, crea trabajo administrativo sin reducir el riesgo.

Para gerencia, responsables de procesos, seguridad y TI, clasificar consiste en acordar qué impacto tendría la divulgación, alteración o indisponibilidad de la información y aplicar un tratamiento coherente con ese impacto. La herramienta puede automatizar parte del trabajo, pero no decide cuánto daño produciría un contrato alterado, un listado de precios divulgado antes de tiempo o un procedimiento crítico inaccesible.

Clasificación de la información basada en impacto

La sensibilidad no depende únicamente de si un documento contiene datos personales. También puede existir información financiera, comercial, estratégica, operativa o técnica cuya pérdida afecte a clientes, decisiones o continuidad. El punto de partida es el efecto para la organización y las personas, no el formato del archivo ni la aplicación donde se guarda.

FIPS 199 utiliza confidencialidad, integridad y disponibilidad para categorizar información según el impacto potencial de un compromiso. Es un estándar dirigido al ámbito federal estadounidense, no una obligación general para empresas chilenas, pero ofrece una referencia útil: un mismo activo puede exigir protección por razones diferentes. Una lista de remuneraciones preocupa por su divulgación; una orden de pago, por una modificación no autorizada; y un instructivo de emergencia, por no estar disponible cuando se necesita.

Pocas categorías, diferencias observables

Un esquema con muchos niveles tiende a producir dudas y clasificaciones inconsistentes. Uno demasiado simple reúne información con riesgos distintos. No existe una cantidad universal de categorías. La empresa necesita las suficientes para que cada nivel cambie reglas de acceso, intercambio, almacenamiento, respaldo, conservación y disposición.

Nombres como público, interno, confidencial o restringido pueden servir como ejemplos, pero no resuelven nada por sí solos. Cada categoría debe responder qué se puede hacer con la información, quién puede autorizar una excepción y qué control se espera. Si dos niveles terminan con exactamente el mismo tratamiento, la distinción merece ser revisada.

El dueño del proceso debe participar

TI puede configurar permisos o herramientas de etiquetado, pero el área propietaria conoce el uso y las consecuencias del dato. Seguridad aporta criterios comunes; Legal y Cumplimiento contrastan obligaciones; y Tecnología verifica si las reglas pueden aplicarse en los sistemas. Delegar toda la decisión en una sola función suele dejar un catálogo técnicamente ordenado y poco conectado con la operación.

La política de seguridad de la información puede establecer el marco y las responsabilidades. El esquema de clasificación traduce esa dirección en decisiones sobre conjuntos concretos de información. No necesita describir cada producto, pero sí permitir que distintas áreas lleguen a resultados comparables ante situaciones equivalentes.

La categoría debe acompañar el ciclo de vida

Una base puede estar bien protegida en su aplicación principal y perder esa condición cuando alguien la exporta a una planilla, la adjunta a un correo o la carga en un servicio no autorizado. Clasificar el sistema sin considerar las copias entrega una visión incompleta. La regla debe seguir a la información dentro de límites técnicamente viables y conocidos.

El mapa de datos personales aborda finalidades, flujos y terceros para ese tipo específico de información. La clasificación empresarial tiene otro alcance: relaciona sensibilidad e impacto con el tratamiento de información personal y no personal. Ambos instrumentos pueden compartir inventarios, pero responden preguntas distintas.

Equipo aplica categorías de clasificación de la información a documentos empresariales
La clasificación debe conservar su efecto cuando la información pasa de archivos físicos a sistemas y copias de trabajo. Ilustración editorial generada con IA.

Comprobar si la clasificación cambia controles reales

El Control 3 de CIS conecta identificar, clasificar, manejar, conservar y eliminar datos. Su salvaguarda 3.7 propone mantener un esquema empresarial, cubrir los tipos sensibles y revisar si la información está categorizada de manera correcta. Esta relación evita medir el programa solo por el número de documentos etiquetados.

Una revisión útil puede tomar muestras de contratos, reportes financieros, respaldos, tickets de soporte o código fuente y reconstruir su tratamiento. Importa observar si el propietario asignado entiende la categoría, si los permisos coinciden con ella, si las copias mantienen el resguardo y si existe evidencia de excepciones. Clasificar todo en el nivel más alto tampoco demuestra madurez: cuando cada archivo parece crítico, los usuarios dejan de distinguir prioridades y los controles más exigentes se vuelven difíciles de sostener.

Pasar de las etiquetas a una capacidad verificable

La clasificación de la información funciona cuando reduce ambigüedad. El área que crea o recibe los datos puede anticipar cómo tratarlos; TI conoce qué controles aplicar; y una revisión puede seguir la decisión desde el criterio hasta la evidencia. Comprar una plataforma antes de resolver esas reglas puede automatizar inconsistencias con mayor velocidad.

Una auditoría de seguridad puede contrastar el esquema declarado con muestras de información, permisos y prácticas de manejo. El objetivo no es multiplicar etiquetas, sino comprobar que la sensibilidad reconocida produce controles proporcionales y decisiones que la organización puede explicar.

Fuentes consultadas

Equipo de una empresa revisa criterios de retención de datos personales

Retención de datos personales: cuándo dejar de conservar

La retención de datos personales suele quedar resuelta por una costumbre: conservar todo mientras exista espacio. Así se acumulan postulaciones antiguas, exportaciones del CRM y carpetas de clientes sin actividad. Para una empresa, el problema es explicar por qué sigue necesitando esos datos, quién responde por ellos y qué ocurrirá cuando termine esa necesidad. Comprar almacenamiento no resuelve esa decisión.

Una política útil conecta cada conjunto de datos con una finalidad, un plazo justificable y un evento que permita calcularlo. Esa definición corresponde al negocio y debe considerar las obligaciones aplicables. TI necesita esas decisiones para implementarlas; no debería tener que inventarlas al configurar una aplicación.

Retención de datos personales: un plazo necesita una razón

No existe un número de años que sirva para toda la información de una empresa. Un documento sujeto a una obligación de conservación y una lista de interesados en una campaña pueden requerir tratamientos distintos. El criterio debe identificar qué obliga o justifica mantener los datos y hasta cuándo. La salvaguarda 3.4 de CIS propone documentar límites mínimos y máximos de retención: conservar menos de lo necesario también puede ser un problema.

En Chile, el artículo 6 de la Ley 19.628 ya contempla eliminar o cancelar datos cuando su almacenamiento carece de fundamento legal o han caducado. Las modificaciones introducidas por la Ley 21.719, con entrada en vigor el 1 de diciembre de 2026, explicitan la conservación limitada al tiempo necesario para la finalidad, con excepciones previstas legalmente. Esto exige revisar cada proceso y sus obligaciones; no autoriza una eliminación masiva basada solamente en la antigüedad del archivo.

Definir desde qué momento corre el plazo

Un plazo resulta ambiguo si nadie sabe cuándo empieza. Puede depender del cierre de una solicitud, del término de una relación contractual o de otro hecho pertinente al proceso. La fecha de creación de una copia no debería reiniciar automáticamente esa cuenta.

Pensemos en selección de personal. Los antecedentes de una candidatura cerrada y los documentos de una persona contratada cumplen finalidades diferentes. Aplicarles una regla idéntica por estar en la misma plataforma evita una decisión incómoda, pero no la resuelve. El dueño del proceso debe explicar la diferencia y validar su tratamiento con quienes conocen las exigencias legales correspondientes.

Las copias también forman parte del problema

Eliminar un registro de la aplicación principal puede dejar intactos sus datos en planillas, correos, ambientes de prueba o servicios externos. Por eso, el mapa de datos personales y sus flujos ayuda a delimitar dónde debe operar la regla. El inventario ubica la información; la política decide cuánto tiempo necesita conservarse.

Los respaldos requieren un tratamiento compatible con su propósito de recuperación. Como criterio de gestión, conviene definir su vencimiento, restringir el uso ordinario de los datos que contienen y prever qué ocurre si una restauración vuelve a introducir registros que ya debían retirarse. Una dificultad técnica necesita una solución evaluada y documentada, no convertirse en una excepción indefinida.

Encargada revisa carpetas de un archivo empresarial para evaluar su conservación
La revisión de conservación alcanza los archivos físicos y las copias digitales. Ilustración editorial generada con IA.

Las excepciones deben tener un responsable

Una controversia, investigación u obligación específica puede justificar suspender la eliminación de determinados antecedentes. La excepción debería delimitar qué información se preserva, su motivo, quién la autoriza y cuándo se revisará. Extender esa suspensión a toda una base de datos por comodidad multiplica la información retenida sin explicar su necesidad.

El Marco de Privacidad de NIST 1.0 relaciona las políticas de tratamiento y retención con responsabilidades y procesos de revisión. Sirve como referencia de gobierno, no como sustituto de la legislación chilena. En la práctica, negocio define la necesidad; asesoría jurídica contrasta obligaciones; y TI evalúa si la regla puede cumplirse en aplicaciones, archivos y proveedores.

Decidir el destino y comprobar el resultado

Cuando termina la conservación justificada, eliminar y anonimizar son decisiones distintas. Quitar el nombre no garantiza anonimato si otros campos permiten identificar a la persona. Si la empresa necesita conservar estadísticas, debe evaluar si puede obtenerlas sin mantener registros identificables. Cuando corresponde retirar soportes, el borrado seguro de datos aborda la ejecución técnica de una decisión que ya debería estar resuelta.

La evidencia útil no se limita a una política aprobada. Una muestra de registros vencidos permite comprobar si la regla funciona, si existen copias olvidadas y si las excepciones siguen justificadas. Los hallazgos deberían llevar a corregir el proceso y asignar responsables, sin convertir la revisión en otra planilla abandonada.

Si la empresa conserva información por inercia, conviene revisar sus criterios antes de automatizar eliminaciones. El servicio de protección de datos personales de AllDefense permite abordar esa conversación desde los procesos y los riesgos de la organización.

Fuentes consultadas