Equipo de TI evaluando la redundancia de conectividad empresarial

Redundancia de conectividad: evitar un respaldo aparente

Contratar dos enlaces de Internet no garantiza una redundancia de conectividad real. Ambos pueden entrar al edificio por el mismo ducto, depender de una infraestructura común o terminar en un único equipo sin respaldo eléctrico. En ese escenario, la empresa paga dos contratos, pero conserva un solo punto de falla.

La pregunta útil no es cuántos proveedores aparecen en la factura, sino qué interrupciones puede resistir la arquitectura y durante cuánto tiempo. Resolverla exige relacionar la conectividad con los procesos que dependen de ella: ventas, telefonía, acceso a servicios en la nube, operación de sucursales, videovigilancia o trabajo remoto.

Cuándo la redundancia de conectividad es solo aparente

Un enlace secundario aporta continuidad cuando reduce la probabilidad de fallar por la misma causa que el principal. La independencia comercial ayuda, pero no basta. Dos operadores pueden compartir fibra mayorista, cámaras subterráneas, postes, nodos de agregación o una misma acometida al edificio. Un corte físico o una falla aguas arriba podría afectar a ambos al mismo tiempo.

También existen dependencias dentro de la empresa. Si los dos enlaces llegan al mismo router, usan una sola fuente eléctrica o requieren una configuración manual que nadie ha probado, el punto débil se trasladó desde el proveedor hacia la instalación local. Lo mismo ocurre cuando el respaldo conserva Internet, pero no permite resolver nombres, autenticar usuarios, establecer la VPN o acceder a las aplicaciones necesarias.

NIST recomienda que los servicios alternativos de telecomunicaciones reduzcan la posibilidad de compartir puntos únicos de falla y, cuando el riesgo lo justifique, estén separados de los servicios principales frente a amenazas comunes. Ese principio convierte la diversidad física y lógica en un requisito verificable, no en una etiqueta comercial.

Diseñar el respaldo desde el impacto operacional

No todas las sedes ni aplicaciones necesitan la misma disponibilidad. Una oficina puede operar temporalmente con acceso limitado, mientras una sucursal que procesa pagos o un recinto que transmite videovigilancia puede requerir continuidad inmediata. Por eso conviene comenzar por los procesos críticos y los objetivos de recuperación, no por la velocidad ofrecida por el segundo enlace.

Los objetivos RTO y RPO ayudan a expresar cuánto tiempo puede permanecer interrumpido un servicio y cuánta información puede perderse. En conectividad, esa definición permite decidir si basta una conmutación manual, si se necesita failover automático o si algunos servicios deben conservar prioridad cuando el enlace alternativo tiene menor capacidad.

Antes de considerar resuelto el riesgo, la organización debería poder demostrar al menos:

  • qué procesos, sedes y servicios dependen de cada conexión;
  • si las rutas físicas y los proveedores comparten infraestructura crítica;
  • qué equipos, energía, DNS, autenticación y seguridad intervienen en la conmutación;
  • qué nivel de operación degradada puede sostener el enlace alternativo;
  • quién decide, ejecuta y verifica el retorno al servicio normal.
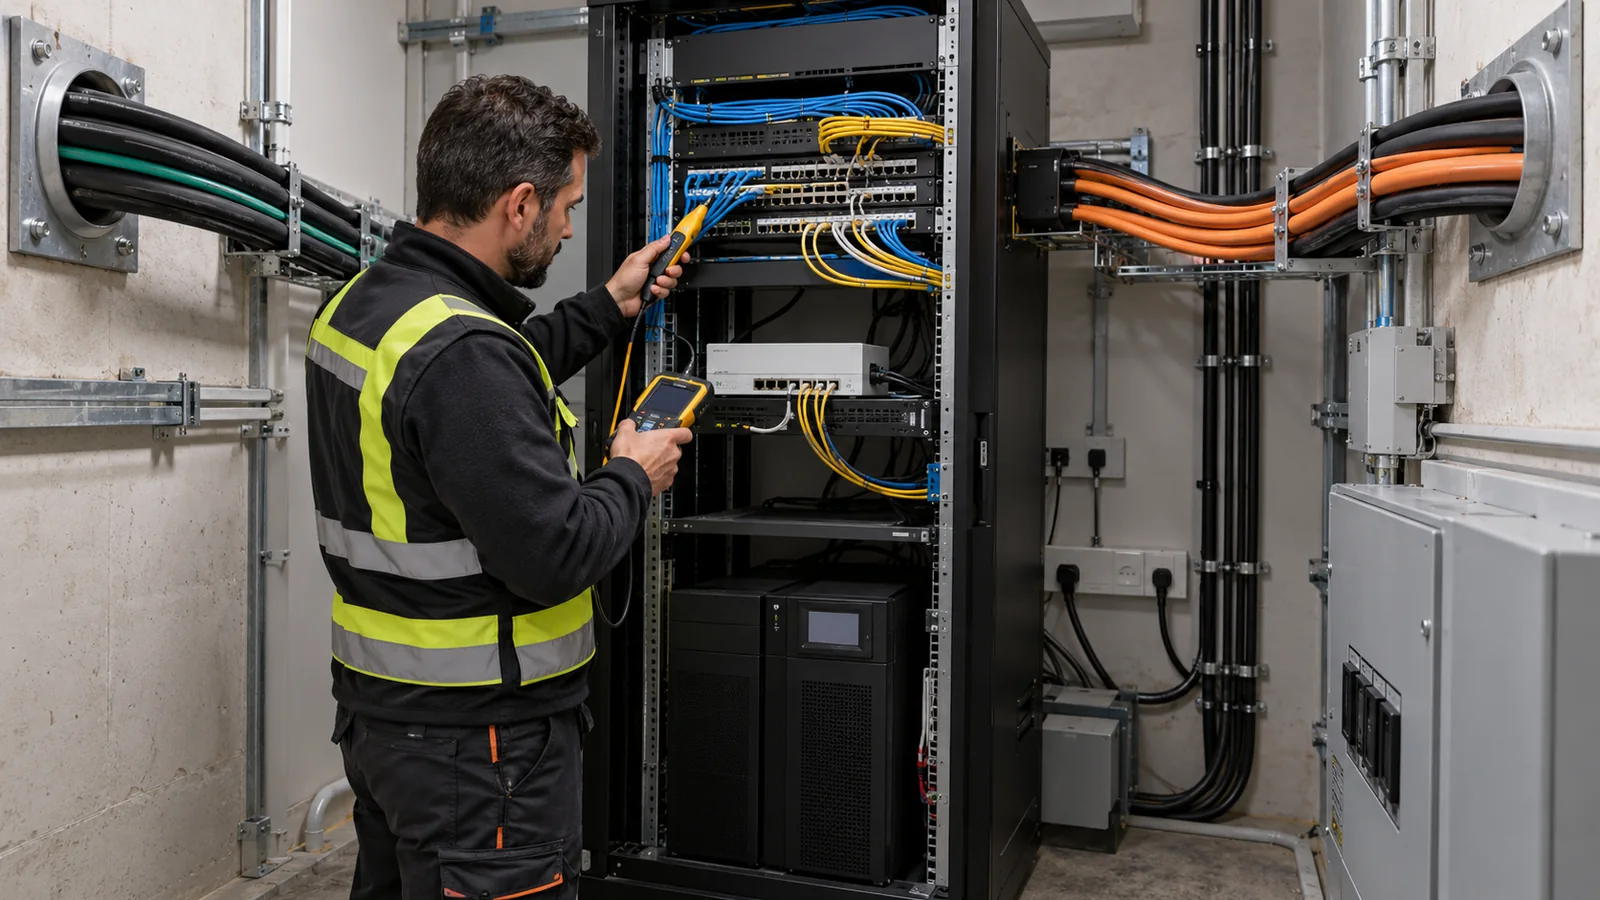
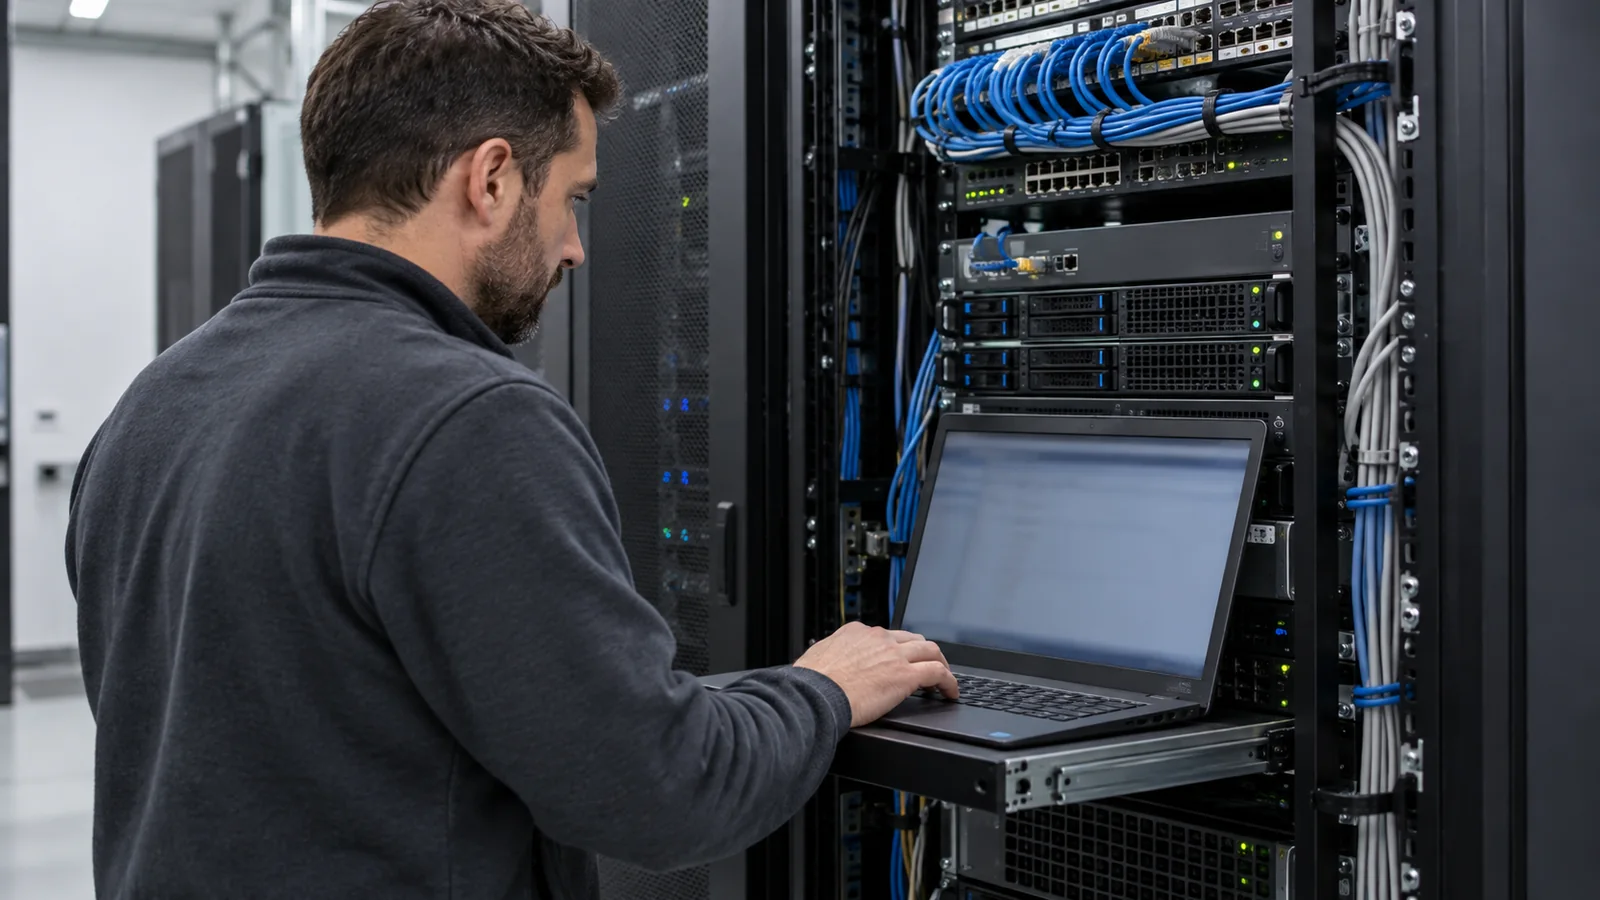
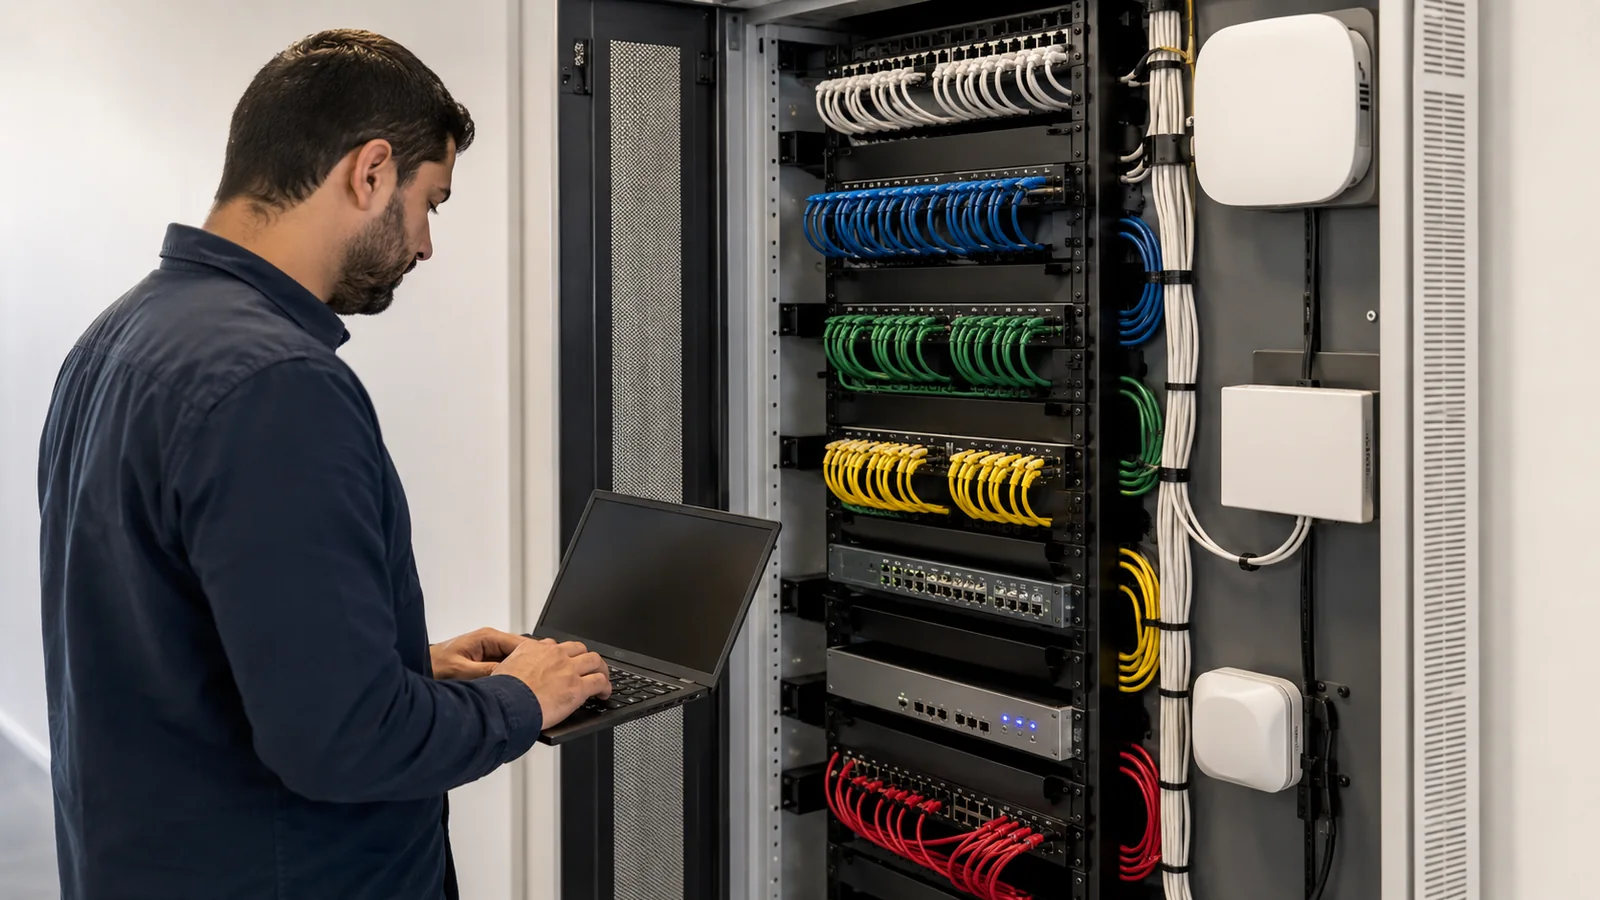
Técnico revisando rutas físicas para la redundancia de conectividad empresarial
La diversidad de rutas, equipos y energía debe comprobarse en la instalación, no presumirse a partir de los contratos.

El failover debe probarse en condiciones controladas

Una configuración de respaldo puede permanecer meses sin utilizarse y fallar justo cuando se necesita. Las rutas cambian, los equipos reciben actualizaciones, aparecen nuevas aplicaciones y se agregan reglas de seguridad. Por eso una prueba no debe limitarse a confirmar que un computador abre una página web.

La validación necesita observar la continuidad de los servicios relevantes, el tiempo real de conmutación, las sesiones que se interrumpen, la capacidad disponible y la generación de alertas. También debe comprobar el retorno al enlace principal. Un mecanismo que recupera conectividad pero deja rutas asimétricas, registros incompletos o sesiones inestables todavía representa un riesgo operacional.

El resultado útil es evidencia: fecha, alcance, comportamiento observado, limitaciones y acciones correctivas. Esa información permite distinguir entre una capacidad demostrada y una expectativa basada en el diseño. Además, entrega a gerencia un criterio para decidir si el nivel de continuidad obtenido corresponde al impacto que se busca reducir.

La disponibilidad no debe debilitar la seguridad

La salida alternativa necesita mantener controles equivalentes. No debería convertirse en un camino con reglas más permisivas, administración expuesta o menor trazabilidad. El control 12 de CIS incluye disponibilidad dentro de una arquitectura de red segura y exige gestionar activamente los dispositivos, configuraciones y documentación de la infraestructura.

Esta revisión se relaciona con el inventario de activos tecnológicos y con la segmentación de red empresarial. Si no se conocen los equipos, enlaces y dependencias, resulta difícil mantener el respaldo o evitar que una conmutación altere los límites de seguridad previstos.

Convertir dos enlaces en una capacidad de continuidad

La redundancia de conectividad se demuestra cuando la empresa conoce sus dependencias, ha reducido las fallas comunes y puede verificar la conmutación sin perder controles esenciales. La velocidad del enlace alternativo importa, pero después de confirmar ruta, energía, equipos, configuración, monitoreo y responsabilidades.

La División de Redes y Sistemas de AllDefense puede apoyar el levantamiento de la arquitectura, sus puntos de falla y los criterios técnicos para una conectividad más resiliente. El objetivo es que el respaldo exista en la operación y no solo en el contrato.

Fuentes consultadas

Equipo de TI y negocio revisa la gestión de certificados TLS

Gestión de certificados TLS: evitar interrupciones por vencimiento

Un portal de clientes puede dejar de funcionar aunque los servidores sigan encendidos. Basta con que venza un certificado y los navegadores o las aplicaciones rechacen la conexión. La gestión de certificados TLS busca evitar esa interrupción mediante un proceso que une inventario, responsables, renovación y comprobación del servicio. Para una empresa chilena que vende, atiende o intercambia información en línea, es una tarea de continuidad con consecuencias concretas para la operación.

El vencimiento es visible; las dependencias suelen quedar ocultas

Un certificado TLS permite al cliente verificar la identidad del servidor dentro de una conexión protegida. Tiene una vigencia definida y debe reemplazarse oportunamente. Contar con uno válido, sin embargo, no demuestra por sí solo que toda la aplicación sea segura. Tampoco alcanza con renovar el certificado de la página principal si otros componentes del servicio conservan versiones anteriores.

Pensemos en un portal que utiliza un balanceador, una API de pedidos y un servicio interno de autenticación. Es un ejemplo hipotético: cualquiera de esas conexiones puede depender de certificados diferentes. La guía NIST SP 1800-16 aborda precisamente los riesgos de gestionar certificados distribuidos entre tecnologías y equipos. Su propuesta incluye políticas, responsabilidades, automatización y monitoreo, tanto para servicios públicos como internos.

Gestión de certificados TLS: un inventario con responsables

El inventario debe permitir responder qué servicio depende del certificado, dónde está instalado, qué nombres cubre, quién lo emite, cuándo vence y qué equipo puede reemplazarlo. Conviene añadir el contacto de escalamiento y la ruta de renovación. Registrar solamente el dominio y la fecha deja fuera información necesaria cuando falla un proceso automático o cambia el proveedor.

NIST recomienda asignar la responsabilidad a grupos funcionales con varias personas, en lugar de depender de un individuo. En la práctica, esto exige un equipo que reciba las alertas, un respaldo durante ausencias y una revisión cuando cambian los contratos o las funciones. Si el alojamiento está tercerizado, hay que acordar quién solicita, instala y valida la renovación, y quién informa un fallo.

La revisión de la superficie de ataque externa puede ayudar a encontrar servicios olvidados. Debe complementarse con información de aplicaciones internas, plataformas de nube y proveedores: lo visible desde internet representa solo una parte del inventario.

Validación del servicio dentro de la gestión de certificados TLS
La comprobación debe alcanzar los equipos que entregan el servicio. Ilustración editorial generada con IA.

Automatizar la renovación y vigilar su resultado

El protocolo ACME, definido en RFC 8555, permite automatizar la interacción entre un cliente y una autoridad certificadora, incluida la validación del control sobre dominios y la emisión de certificados. Su uso reduce intervenciones manuales, pero la empresa todavía necesita integrar la instalación y comprobar el resultado en sus plataformas.

Un certificado recién emitido puede quedar en un repositorio sin llegar a todos los servidores. Por eso, el flujo debe contemplar solicitud, despliegue, recarga del servicio cuando corresponda y validación posterior. Las credenciales que permiten automatizar estas acciones requieren permisos limitados y protección. Las claves privadas no deben circular por correos o tickets como si fueran archivos ordinarios.

La anticipación debe dejar tiempo para resolver errores y repetir las pruebas. Es preferible definir ese margen según la vigencia, la criticidad y las ventanas de cambio, en vez de copiar un plazo para todos los certificados. También conviene probar qué sucede si la automatización falla y nadie recibe su primera alerta.

Comprobar lo que recibe el usuario

Después del reemplazo, hay que verificar el certificado presentado por el servicio: nombres correctos, vigencia, cadena de confianza y funcionamiento desde los clientes relevantes. En una plataforma con varios nodos, la comprobación debe cubrir cada punto que atiende conexiones. Una transacción de prueba, sin datos sensibles, puede revelar dependencias que la consola de emisión no muestra.

NIST recomienda probar la aplicación tras la renovación y monitorear continuamente los certificados. Como criterio operativo, conviene que ese monitoreo observe el servicio real y no dependa únicamente del mensaje de éxito del proceso que lo renovó. Así se puede detectar que la emisión terminó correctamente, pero el despliegue quedó incompleto.

Qué debería revisar la dirección

Un reporte útil muestra servicios críticos con responsable identificado, renovaciones próximas sin validar, fallos de automatización pendientes y tiempo necesario para resolverlos. Son indicadores de gestión propuestos para orientar decisiones; no constituyen una exigencia universal de NIST. La dirección puede usarlos para priorizar dependencias que concentran más impacto, en lugar de recibir una lista extensa de fechas sin contexto.

El primer paso puede ser acotado: elegir un servicio importante, reconstruir sus dependencias y observar una renovación completa. La revisión de redes y sistemas permite situar este trabajo dentro de la infraestructura que sostiene la operación. Con responsables claros y evidencia del resultado, la empresa puede ampliar el proceso a otros servicios sin depender de que alguien recuerde revisar un calendario.

Fuentes

Profesionales evaluando infraestructura tecnológica antigua y su renovación

Tecnología sin soporte: cuándo renovar, aislar o retirar

La tecnología sin soporte suele permanecer en una empresa por una razón comprensible: todavía funciona. El servidor permite facturar, el equipo controla una máquina o la aplicación guarda información que nadie quiere perder. Sin embargo, que un sistema siga encendido no significa que su fabricante vaya a corregir la próxima vulnerabilidad. La decisión útil para la gerencia no es reemplazar todo de inmediato, sino resolver qué renovar, qué aislar temporalmente y qué retirar.

Esa diferencia cambia la conversación presupuestaria. Un activo antiguo puede ser manejable durante una transición; uno expuesto a internet y sin actualizaciones puede requerir una medida inmediata. La prioridad depende del servicio que sostiene, sus conexiones y las alternativas disponibles, no solo del año de compra.

Qué significa tener tecnología sin soporte

El fin del soporte depende del producto, su versión y las condiciones del proveedor. Puede afectar actualizaciones de seguridad, asistencia técnica, repuestos o compatibilidad. Por eso conviene comprobar la política oficial y el contrato, en lugar de asumir que todos esos beneficios terminan juntos.

Por ejemplo, la política de ciclo de vida fijo de Microsoft distingue soporte principal, extendido y determinadas opciones de actualizaciones posteriores. Una extensión contratada puede dar tiempo para migrar, pero debe verificarse su cobertura real. Tampoco convierte una plataforma antigua en una solución indefinida.

El inventario debería identificar versión, responsable, servicio asociado, fecha de término y evidencia del proveedor. El Control 2 de CIS propone gestionar activamente los activos de software. Sin esa base, las compras responden a urgencias y quedan dependencias fuera del presupuesto.

Cómo ordenar las prioridades sin detener el negocio

Primero, pregunte qué ocurre si el equipo deja de estar disponible. No pesa lo mismo un computador de consulta que el único servidor capaz de emitir documentos operativos. Después revise quién puede conectarse, qué privilegios utiliza y si existe una alternativa probada.

Un ejemplo hipotético: una empresa mantiene una aplicación de bodega que solo opera sobre un sistema antiguo. Antes de comprar hardware, necesita saber si podrá migrar la base de datos, conectar los lectores y recuperar el servicio. Renovar el servidor sin resolver esas dependencias puede trasladar el problema a un equipo nuevo.

La revisión de la superficie de ataque externa ayuda a detectar activos accesibles desde internet. Esa exposición debe entrar en la decisión, junto con la criticidad y la posibilidad de recuperación. No es necesario esperar a que exista una alerta pública para identificar un equipo sin responsable o una plataforma abandonada.

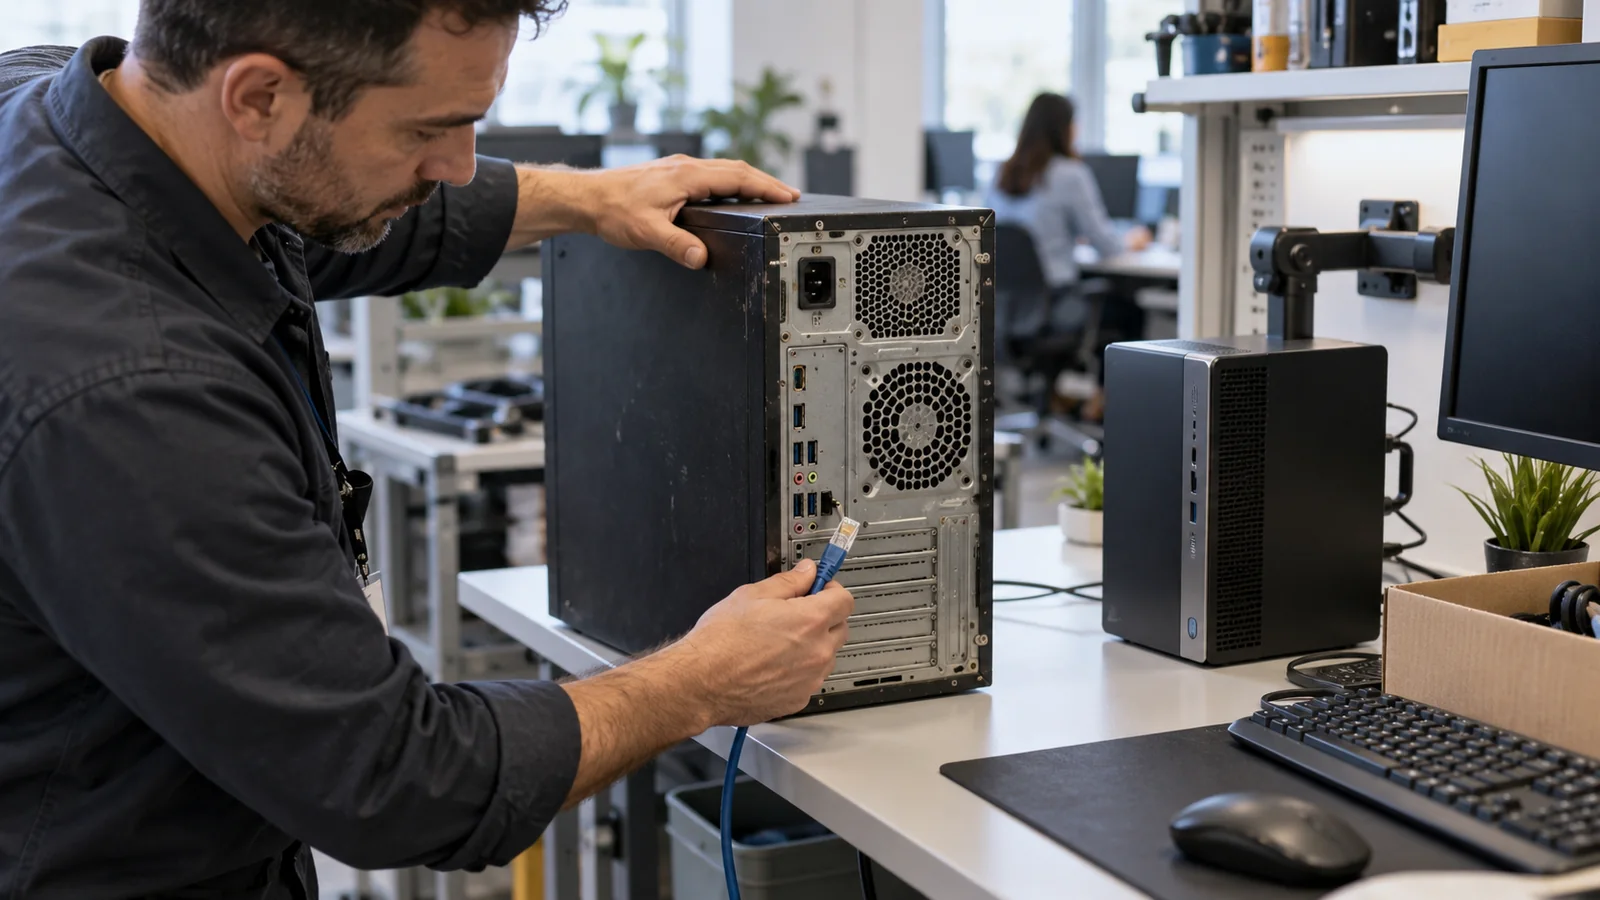
Técnico desconectando un equipo antiguo para su retiro controlado
La transición debe contemplar las conexiones, los datos y el servicio que depende del equipo.

Renovar, aislar o retirar: tres decisiones distintas

Renovar cuando el servicio sigue siendo necesario

Actualizar o reemplazar tiene sentido cuando la función sigue aportando valor. Incluya pruebas de compatibilidad, licencias, migración, capacitación y una ventana de cambio. Antes del paso a producción, acuerde criterios de aceptación y una forma segura de volver atrás si la prueba falla.

NIST presenta la gestión de parches como mantenimiento preventivo de la tecnología, con participación de responsables de negocio y TI. Aplicado a esta decisión, el presupuesto debe cubrir la continuidad del mantenimiento y no únicamente la instalación inicial.

Aislar como excepción temporal

Cuando la sustitución necesita preparación, limitar comunicaciones puede reducir exposición. Una segmentación de red bien definida permite autorizar solo los flujos necesarios. También conviene restringir la administración, retirar accesos innecesarios y vigilar conexiones inesperadas.

Estas medidas no reparan el software ni garantizan que sea seguro. La excepción necesita un dueño, controles comprobables y una fecha de salida. Si cada revisión termina aplazando esa fecha sin recursos asignados, la transición se ha convertido en permanencia.

Retirar cuando ya no existe una necesidad justificada

Apagar no basta. Compruebe las dependencias, preserve la información que corresponda, revoque credenciales y certificados, cierre accesos y actualice el inventario. El tratamiento de los discos debe ajustarse a la sensibilidad de los datos y a las obligaciones de conservación aplicables. Un equipo fuera de uso tampoco debería seguir habilitando acceso remoto.

Qué debería quedar aprobado

La decisión puede resumirse en una ficha: activo y servicio, evidencia del fin de soporte, impacto de falla, alternativa elegida, responsable, presupuesto y plazo. Agregue cómo se probará la recuperación y quién aceptará el resultado. Así, gerencia puede distinguir una inversión necesaria de una excepción que acumula riesgo.

El objetivo no es eliminar toda tecnología antigua, sino evitar dependencias sin una salida viable. AllDefense puede acompañar la evaluación de redes y sistemas para convertir ese inventario en un plan de renovación coherente con la operación.

Equipo revisando la segmentación de red empresarial y sus zonas de seguridad

Segmentación de red empresarial: cómo limitar un incidente

Cuando impresoras, cámaras, notebooks, servidores y sistemas de gestión comparten una red con pocas restricciones, un problema localizado puede transformarse en una interrupción amplia. La segmentación de red empresarial reduce ese riesgo: separa entornos con funciones y niveles de confianza distintos, y controla qué comunicaciones pueden cruzar entre ellos. No evita por sí sola un incidente, pero limita sus caminos y facilita detectar comportamientos fuera de lo esperado.

Por qué una red plana amplifica el impacto

Muchas redes crecen de forma acumulativa. Se agrega una sucursal, una red inalámbrica, cámaras IP, telefonía, acceso remoto o una plataforma nueva, pero la arquitectura original se mantiene. El resultado suele ser una conectividad cómoda para operar y también para desplazarse: si un equipo queda comprometido, puede alcanzar servicios que nunca necesitó usar.

La consecuencia no se limita a los ciberataques. Una configuración incorrecta, un dispositivo defectuoso o una tormenta de tráfico también puede afectar áreas que deberían permanecer independientes. Segmentar ayuda a contener fallas, acotar diagnósticos y conservar funciones esenciales mientras se resuelve el problema.

La segmentación de red empresarial no es solo crear VLAN

Una VLAN puede separar tráfico, pero el valor de seguridad aparece cuando esa división responde a una decisión de negocio y existen controles entre las zonas. Si todas pueden comunicarse libremente, la separación será principalmente administrativa. El diseño debe considerar qué activos hay, quién los utiliza, qué dependencias son legítimas y qué ocurriría si una zona quedara indisponible o fuera comprometida.

Técnico revisa equipos de red separados por funciones en una empresa

Por eso no existe una plantilla universal. Una empresa puede necesitar separar usuarios, servidores, invitados, telefonía y cámaras; otra deberá distinguir además ambientes productivos, laboratorios, sucursales o infraestructura operacional. La arquitectura útil es la que refleja cómo funciona la organización y protege lo que realmente sostiene su operación.

Separar por función, confianza y consecuencia

Un criterio razonable combina tres preguntas. Primero, ¿qué función cumple el activo? Segundo, ¿cuánto control existe sobre él? Un notebook administrado no ofrece el mismo nivel de confianza que un dispositivo personal o el equipo de un proveedor. Tercero, ¿cuál sería la consecuencia de un acceso indebido? Un sistema crítico o un servidor de respaldo merece límites más estrictos que una red de visitas.

Esta mirada evita dos extremos: mantener todo conectado por comodidad o crear tantas zonas que la operación se vuelva inmanejable. La segmentación debe ser suficientemente clara para reducir exposición, pero también comprensible para quienes administran la red. Un diagrama actualizado y responsables definidos son tan importantes como la configuración de los equipos.

El control entre zonas vuelve útil la separación

Cada comunicación permitida debería tener una razón. Las reglas pueden considerar origen, destino, servicio, identidad del usuario o condición del dispositivo, según la madurez y tecnología disponible. El principio práctico es habilitar solo lo necesario y registrar los intentos relevantes, especialmente alrededor de sistemas sensibles y accesos de administración.

Esto coincide con el enfoque de confianza cero de NIST: la ubicación dentro de la red no debería otorgar confianza implícita. También complementa la recomendación de CIS de diseñar una arquitectura que contemple segmentación, mínimo privilegio y disponibilidad. Segmentar, entonces, no reemplaza la gestión de identidades, la protección de endpoints ni el monitoreo; les entrega un contexto más controlable.

Señales de que conviene revisar la arquitectura

No es necesario esperar un incidente. Hay señales cotidianas que justifican una revisión: crecimiento rápido, equipos conectados sin inventario, Wi-Fi de invitados que alcanza recursos internos, cámaras y controles de acceso en la misma red de usuarios, proveedores con accesos amplios o reglas antiguas cuyo propósito ya nadie conoce. También es relevante cuando una empresa adopta servicios en la nube o integra una nueva sucursal.

La guía de CISA sobre ransomware señala que la segmentación puede contener el impacto de una intrusión y limitar el movimiento lateral. Esa capacidad depende de que las barreras estén realmente aplicadas y probadas. Una zona crítica que conserva excepciones excesivas puede parecer aislada en el diagrama y no estarlo en la práctica.

Reducir la propagación sin paralizar la operación

La transición funciona mejor por etapas. Antes de cambiar reglas conviene observar flujos, documentar dependencias y priorizar los activos cuya indisponibilidad tendría mayor efecto. Luego se puede probar una separación acotada, medir interrupciones y ajustar. Este enfoque disminuye el riesgo de bloquear procesos legítimos y permite demostrar valor con resultados concretos.

AllDefense puede apoyar el diagnóstico y diseño desde su división de Redes y Sistemas, integrando conectividad, infraestructura y controles de seguridad. Cuando el punto de partida no está claro, una auditoría de seguridad permite identificar rutas innecesarias, dependencias críticas y prioridades antes de intervenir la operación. El objetivo no es acumular complejidad, sino reducir el alcance posible de una falla o intrusión.

Fuentes consultadas

CISA: StopRansomware Guide; NIST SP 800-207: Zero Trust Architecture; CIS Control 12: Network Infrastructure Management.