Equipo de TI y negocio revisa la gestión de certificados TLS

Gestión de certificados TLS: evitar interrupciones por vencimiento

Un portal de clientes puede dejar de funcionar aunque los servidores sigan encendidos. Basta con que venza un certificado y los navegadores o las aplicaciones rechacen la conexión. La gestión de certificados TLS busca evitar esa interrupción mediante un proceso que une inventario, responsables, renovación y comprobación del servicio. Para una empresa chilena que vende, atiende o intercambia información en línea, es una tarea de continuidad con consecuencias concretas para la operación.

El vencimiento es visible; las dependencias suelen quedar ocultas

Un certificado TLS permite al cliente verificar la identidad del servidor dentro de una conexión protegida. Tiene una vigencia definida y debe reemplazarse oportunamente. Contar con uno válido, sin embargo, no demuestra por sí solo que toda la aplicación sea segura. Tampoco alcanza con renovar el certificado de la página principal si otros componentes del servicio conservan versiones anteriores.

Pensemos en un portal que utiliza un balanceador, una API de pedidos y un servicio interno de autenticación. Es un ejemplo hipotético: cualquiera de esas conexiones puede depender de certificados diferentes. La guía NIST SP 1800-16 aborda precisamente los riesgos de gestionar certificados distribuidos entre tecnologías y equipos. Su propuesta incluye políticas, responsabilidades, automatización y monitoreo, tanto para servicios públicos como internos.

Gestión de certificados TLS: un inventario con responsables

El inventario debe permitir responder qué servicio depende del certificado, dónde está instalado, qué nombres cubre, quién lo emite, cuándo vence y qué equipo puede reemplazarlo. Conviene añadir el contacto de escalamiento y la ruta de renovación. Registrar solamente el dominio y la fecha deja fuera información necesaria cuando falla un proceso automático o cambia el proveedor.

NIST recomienda asignar la responsabilidad a grupos funcionales con varias personas, en lugar de depender de un individuo. En la práctica, esto exige un equipo que reciba las alertas, un respaldo durante ausencias y una revisión cuando cambian los contratos o las funciones. Si el alojamiento está tercerizado, hay que acordar quién solicita, instala y valida la renovación, y quién informa un fallo.

La revisión de la superficie de ataque externa puede ayudar a encontrar servicios olvidados. Debe complementarse con información de aplicaciones internas, plataformas de nube y proveedores: lo visible desde internet representa solo una parte del inventario.
Validación del servicio dentro de la gestión de certificados TLS
La comprobación debe alcanzar los equipos que entregan el servicio. Ilustración editorial generada con IA.

Automatizar la renovación y vigilar su resultado

El protocolo ACME, definido en RFC 8555, permite automatizar la interacción entre un cliente y una autoridad certificadora, incluida la validación del control sobre dominios y la emisión de certificados. Su uso reduce intervenciones manuales, pero la empresa todavía necesita integrar la instalación y comprobar el resultado en sus plataformas.

Un certificado recién emitido puede quedar en un repositorio sin llegar a todos los servidores. Por eso, el flujo debe contemplar solicitud, despliegue, recarga del servicio cuando corresponda y validación posterior. Las credenciales que permiten automatizar estas acciones requieren permisos limitados y protección. Las claves privadas no deben circular por correos o tickets como si fueran archivos ordinarios.

La anticipación debe dejar tiempo para resolver errores y repetir las pruebas. Es preferible definir ese margen según la vigencia, la criticidad y las ventanas de cambio, en vez de copiar un plazo para todos los certificados. También conviene probar qué sucede si la automatización falla y nadie recibe su primera alerta.

Comprobar lo que recibe el usuario

Después del reemplazo, hay que verificar el certificado presentado por el servicio: nombres correctos, vigencia, cadena de confianza y funcionamiento desde los clientes relevantes. En una plataforma con varios nodos, la comprobación debe cubrir cada punto que atiende conexiones. Una transacción de prueba, sin datos sensibles, puede revelar dependencias que la consola de emisión no muestra.

NIST recomienda probar la aplicación tras la renovación y monitorear continuamente los certificados. Como criterio operativo, conviene que ese monitoreo observe el servicio real y no dependa únicamente del mensaje de éxito del proceso que lo renovó. Así se puede detectar que la emisión terminó correctamente, pero el despliegue quedó incompleto.

Qué debería revisar la dirección

Un reporte útil muestra servicios críticos con responsable identificado, renovaciones próximas sin validar, fallos de automatización pendientes y tiempo necesario para resolverlos. Son indicadores de gestión propuestos para orientar decisiones; no constituyen una exigencia universal de NIST. La dirección puede usarlos para priorizar dependencias que concentran más impacto, en lugar de recibir una lista extensa de fechas sin contexto.

El primer paso puede ser acotado: elegir un servicio importante, reconstruir sus dependencias y observar una renovación completa. La revisión de redes y sistemas permite situar este trabajo dentro de la infraestructura que sostiene la operación. Con responsables claros y evidencia del resultado, la empresa puede ampliar el proceso a otros servicios sin depender de que alguien recuerde revisar un calendario.

Fuentes

Equipo revisa copias de seguridad contra ransomware en una sala técnica

Copias de seguridad contra ransomware: recuperar con confianza

Las copias de seguridad contra ransomware no se evalúan por la cantidad de tareas que terminan en verde. La pregunta útil es otra: si un atacante obtiene privilegios, altera sistemas y busca destruir la capacidad de recuperación, ¿la empresa conserva una copia íntegra, accesible por una ruta independiente y capaz de devolver un servicio a un estado confiable? Responderla exige mirar arquitectura, identidades y pruebas, no solo capacidad de almacenamiento.

Por qué una copia disponible puede fallar durante la crisis

La plataforma de respaldo forma parte del entorno que se intenta proteger. Si utiliza las mismas cuentas administrativas, el mismo directorio, la misma red y las mismas consolas que producción, una intrusión con privilegios puede alcanzar también catálogos, políticas de retención, instantáneas y repositorios. El respaldo existe, pero comparte el camino de compromiso.

También hay fallas menos visibles. Un trabajo puede completar sin contener todos los datos y configuraciones necesarios para levantar el servicio. Una copia cifrada puede ser eliminada por una cuenta comprometida o depender de llaves, DNS e identidades que nadie incluyó en el alcance. Por eso, el objetivo del CIS Control 11 es restaurar activos a un estado anterior y confiable, no acumular copias.

Copias de seguridad contra ransomware: separar control y destino

Una estrategia resistente necesita al menos una instancia de recuperación aislada. El aislamiento puede ser físico, lógico o temporal. Una copia fuera de línea queda desconectada cuando no se utiliza; una copia inmutable impide modificar o borrar objetos durante un periodo definido. Son capacidades distintas y ninguna reemplaza la revisión de accesos, retención e integridad.

La separación debe alcanzar el plano administrativo. Conviene evitar que una sola identidad pueda controlar producción y destruir todas las versiones recuperables. Las cuentas de respaldo, las credenciales de emergencia y las llaves de cifrado requieren propietarios definidos, autenticación reforzada, privilegios limitados y trazabilidad. La gestión de accesos privilegiados es especialmente relevante aquí: proteger el repositorio sirve de poco si la consola que gobierna su retención queda expuesta a las mismas credenciales.

Especialistas revisan copias de seguridad contra ransomware en un entorno aislado
Separar la administración de respaldos reduce la posibilidad de que un mismo compromiso alcance producción y recuperación. Ilustración editorial generada con IA.

Recuperar a un estado confiable, no solo abrir archivos

La prueba decisiva es restaurar. Verificar un archivo o ejecutar una validación automática aporta evidencia de integridad, pero no demuestra que una aplicación funcionará con sus dependencias. Una prueba representativa debe comprobar datos, configuración, identidad, conectividad y secuencia de inicio. También debe registrar cuánto tardó el proceso, qué intervención manual exigió y qué diferencias aparecieron frente al objetivo previsto.

Esto conecta con los objetivos RTO y RPO, aunque no los repite. RTO y RPO expresan la tolerancia del negocio; la restauración demuestra si la arquitectura puede cumplirla. Si una base de datos vuelve dentro del plazo, pero la aplicación depende de un directorio o certificado no recuperado, el servicio sigue indisponible. El indicador útil debe llegar hasta una función operativa verificable.

NIST SP 800-184 recomienda planificar la recuperación, priorizar recursos y usar escenarios realistas para probarla y mejorarla. Frente a ransomware, además, plantea inventariar los respaldos y comprobar que no hayan sido cifrados antes de iniciar la restauración. Esa comprobación evita devolver a producción datos dañados o reintroducir condiciones que mantengan el incidente.

Qué evidencia debería revisar la dirección

La dirección no necesita administrar la plataforma, pero sí pedir evidencia comprensible: alcance de los servicios cubiertos, fecha y resultado de la última copia, existencia de una instancia aislada, responsables autorizados, última restauración probada y tiempo realmente observado. Las excepciones deben indicar qué queda fuera, por cuánto tiempo y qué medida compensatoria se aplicará.

El resultado de una prueba también debe mostrar la calidad del punto recuperado. Restaurar el archivo correcto no basta si contiene información inconsistente, cuentas no autorizadas o una configuración vulnerable. La validación requiere participación del dueño del servicio, porque solo el área usuaria puede confirmar que el proceso recuperado cumple su función y que los datos corresponden al momento esperado.

La secuencia de recuperación cambia el resultado

Recuperar demasiado pronto puede contaminar nuevamente el entorno. Antes de restaurar, el equipo debe comprender el alcance, contener el acceso del atacante y preparar una base limpia. Identidades, servicios de red y plataformas de administración suelen ser dependencias previas de las aplicaciones.

Esta coordinación se puede validar mediante un simulacro de ciberseguridad que obligue a decidir qué restaurar, quién autoriza el retorno y qué evidencia permite declarar el servicio confiable. El ejercicio revela dependencias y permisos faltantes sin esperar una crisis real.

Convertir el respaldo en una capacidad verificable

La decisión no comienza por comprar más almacenamiento. Comienza por identificar servicios críticos, trazar sus dependencias y comprobar si producción y recuperación comparten rutas de administración. Con ese diagnóstico se puede definir aislamiento, retención, control de accesos y pruebas acordes con el impacto.

Una auditoría de seguridad puede contrastar la arquitectura declarada con evidencia de configuraciones, permisos, alertas y restauraciones. El valor está en detectar dónde una copia aparentemente disponible deja de ser recuperable. Cuando esa brecha se conoce antes del incidente, la empresa puede corregirla con prioridades claras y demostrar que su continuidad no depende de una suposición.

Fuentes

Equipo participa en un programa de concientización en ciberseguridad

Programa de concientización en ciberseguridad: medir cambios, no asistencia

Un programa de concientización en ciberseguridad puede alcanzar asistencia completa y no cambiar la respuesta cuando una persona recibe una solicitud urgente, detecta una exposición de datos o debe informar una actividad sospechosa. Completar cursos demuestra cobertura administrativa. Para conocer la eficacia se necesita observar si las personas reconocen situaciones relevantes, toman decisiones esperadas y utilizan los canales definidos por la empresa.

Definir la conducta antes de preparar el contenido

El punto de partida no debería ser elegir una plataforma o distribuir un curso genérico, sino precisar qué riesgo necesita reducir la organización. Finanzas puede requerir criterios para validar cambios de cuentas bancarias; quienes administran sistemas, reconocer solicitudes anómalas de acceso; una jefatura, escalar una posible filtración sin esperar certeza técnica. El contenido cambia cuando la conducta esperada está definida.

La publicación NIST SP 800-50 Rev. 1 propone gestionar el aprendizaje como un ciclo y distinguir metas, objetivos y resultados observables. Ese enfoque evita confundir “explicar phishing” con “lograr que una solicitud sospechosa sea validada y reportada”. También permite segmentar: todas las personas requieren una base común, mientras quienes poseen privilegios o responsabilidades específicas necesitan formación asociada a su función.

Qué medir en un programa de concientización en ciberseguridad

Asistencia, finalización y resultados de una prueba siguen siendo útiles, pero responden preguntas limitadas: quién recibió el contenido y qué pudo recordar en ese momento. Para evaluar impacto conviene combinar esa información con evidencia de comportamiento y con observaciones cualitativas. NIST recomienda vincular las métricas con los objetivos de aprendizaje y considerar capacidades, actitudes y cambios de conducta, no solo cumplimiento.

Una organización puede observar los reportes correctos ante mensajes sospechosos, el uso de canales aprobados, la adopción de autenticación multifactor cuando depende del usuario o la capacidad de aplicar un procedimiento semanas después. Entrevistas breves y observaciones de facilitadores ayudan a explicar por qué un resultado mejora o se estanca. La combinación evita decidir con una cifra aislada.

Tampoco corresponde atribuir cada incidente a una falla de capacitación. El número de eventos depende de controles técnicos, exposición, procesos y actividad de amenazas. Un aumento de reportes puede indicar mayor atención, no un deterioro. La métrica útil necesita contexto, una línea base comparable y una pregunta de gestión: qué conducta se busca fortalecer y qué decisión cambiará según el resultado.

Profesionales revisan métricas de un programa de concientización en ciberseguridad
Las métricas aportan valor cuando explican conductas y orientan ajustes del programa.

Las simulaciones deben enseñar, no castigar

Una simulación de phishing puede mostrar quién reportó, abrió un adjunto o siguió un enlace, pero no resume la cultura de seguridad. La dificultad, el contexto y la familiaridad con el canal alteran el resultado. Conviene comparar escenarios equivalentes y observar si el mecanismo de reporte resulta accesible y conocido.

NIST aconseja tratar estas actividades como oportunidades de aprendizaje, comunicar que se realizarán ejercicios aleatorios y evitar exponer o sancionar a una persona por su respuesta. También recomienda revisión legal, especialmente al usar marcas, beneficios o temas personales capaces de generar efectos fuera del ejercicio. El propósito es descubrir dónde reforzar capacidades.

El phishing es solo una modalidad. Casos breves sobre pérdida de equipos, uso de aplicaciones no autorizadas, manejo de información personal o solicitudes urgentes de un proveedor pueden revelar brechas más cercanas al trabajo cotidiano. Para equipos con responsabilidades críticas, un simulacro de ciberseguridad permite evaluar coordinación y decisiones que una capacitación individual no alcanza a observar.

Medir por función sin crear vigilancia innecesaria

Un programa común entrega lenguaje compartido, pero la evidencia debe reflejar las responsabilidades. En atención de clientes interesa el manejo y escalamiento de datos; en compras, la validación de proveedores; en administración tecnológica, el uso de cuentas privilegiadas y cambios; en gerencia, la capacidad de reconocer fraude ejecutivo y activar apoyo. Comparar a todas las áreas con una misma prueba oculta esas diferencias.

Los resultados pueden formar parte de registros laborales y contener información sensible sobre desempeño. Se debe definir quién accede, cuánto se conserva, qué detalle llega a la gerencia y para qué se utilizará. Los reportes agregados suelen bastar para orientar el programa. La identificación individual debería reservarse para apoyos concretos u obligaciones justificadas.

Convertir resultados en una mejora verificable

La revisión debe conectar cada hallazgo con una acción. Si las personas reconocen un mensaje dudoso pero no saben dónde reportarlo, el problema puede estar en el canal. Si un área falla ante cambios de datos bancarios, quizá se necesite ajustar el proceso además de capacitar. Cuando la retención cae, conviene introducir refuerzos breves en el trabajo.

El CIS Control 14 sitúa la concientización como un programa mantenido para influir en conductas y desarrollar habilidades. El NIST Cybersecurity Framework 2.0 permite relacionar esos resultados con objetivos más amplios de gestión del riesgo. En la práctica, la evidencia debería alimentar la aplicación de la política de seguridad, las prioridades de cada área y la planificación del siguiente ciclo.

AllDefense puede apoyar este trabajo mediante su servicio de Concientización en Seguridad, diseñando actividades relacionadas con riesgos y funciones reales. Cuando el desafío incluye gobierno, indicadores y responsabilidades entre áreas, la Asesoría Estratégica ayuda a convertir la capacitación en una capacidad gestionable. La señal de avance no es haber enviado más contenidos, sino contar con mejores decisiones y evidencia suficiente para sostenerlas.

Fuentes consultadas

Equipo de TI, seguridad y operaciones revisa una configuración segura antes del despliegue

Configuración segura: evitar que el desvío se vuelva norma

Una configuración segura puede deteriorarse sin que exista un ataque. Basta una regla temporal que nunca se retira, un servicio habilitado para resolver una urgencia o una plantilla que deja de reflejar la operación real. Cuando cada cambio parece razonable por separado, el desvío termina convertido en la configuración normal y la empresa pierde una referencia confiable para evaluar sus equipos.

El objetivo no es endurecer todos los sistemas al máximo. Es acordar una línea base que reduzca exposición sin impedir la función del activo, controlar los cambios y mantener evidencia suficiente para distinguir una decisión aprobada de una diferencia que nadie puede explicar.

Una configuración segura comienza con una línea base útil

La guía NIST SP 800-128 describe la gestión de configuración enfocada en seguridad como parte de la gestión de riesgo. Su propósito es establecer, controlar y vigilar configuraciones mientras se conserva la funcionalidad que el negocio necesita. Esto evita tratar la seguridad como una lista aislada de parámetros.

Una línea base debe indicar a qué familia y versión de activos aplica, quién la aprueba, qué dependencias condicionan sus ajustes y cómo se comprobará. También necesita una versión identificable. Una planilla sin dueño o una captura de pantalla antigua no permite saber si el servidor observado está correctamente configurado o si la referencia quedó obsoleta.

Conviene comenzar por grupos acotados y comparables: estaciones corporativas, servidores con una misma función, equipos de red o plataformas en la nube. Mezclar activos con propósitos distintos produce una línea base tan genérica que cualquier resultado puede parecer aceptable.

Controlar cambios sin congelar la operación

Una configuración aprobada no debe impedir el cambio. Debe permitir reconstruir por qué ocurrió, quién evaluó su impacto, cómo se probó y qué alternativa existe si falla. La familia de gestión de configuración de NIST SP 800-53 Rev. 5 reúne controles sobre líneas base, cambios, parámetros y componentes. La utilidad empresarial está en conectar esas decisiones con el proceso habitual de cambios, no en crear un circuito paralelo que el equipo terminará evitando.

La evidencia mínima depende del impacto. Cambiar una preferencia local no requiere la misma revisión que abrir un servicio a internet o desactivar una protección en cientos de equipos. Definir umbrales permite reservar una aprobación más exigente para cambios que alteran exposición, privilegios, registros, cifrado o recuperación.

Especialistas comparan una configuración segura aprobada con el estado de un servidor
Comparar el estado observado con una línea base permite detectar desvíos y revisar excepciones. Ilustración editorial generada con IA.

Detectar el desvío antes de normalizarlo

El desvío de configuración aparece cuando el estado observado deja de coincidir con la referencia aprobada. Una herramienta puede encontrar la diferencia, pero no decidir por sí sola si se trata de un error, una excepción vigente o una actualización pendiente de incorporar a la línea base. Esa clasificación necesita contexto y un responsable.

Medir todo con la misma frecuencia tampoco aporta el mismo valor. Los activos expuestos, las consolas administrativas y los servicios críticos merecen una detección más cercana que equipos aislados de bajo impacto. Los logs de seguridad ayudan a reconstruir quién realizó el cambio y cuándo, siempre que las identidades sean atribuibles y los eventos relevantes estén definidos de antemano.

Las excepciones deben tener vencimiento

Una línea base rígida puede generar excepciones informales. Resulta preferible reconocerlas y decidirlas. Cada excepción debería registrar el activo y el parámetro afectados, la razón operativa, el riesgo aceptado, los controles compensatorios, el responsable y una fecha de revisión o cierre. Sin vencimiento, una necesidad temporal se transforma en una deuda invisible.

Revisar una excepción no significa renovarla automáticamente. Se debe comprobar si la causa continúa, si el activo cambió y si apareció una alternativa. Cuando la excepción afecta tecnología que ya no recibe soporte, la decisión también debe considerar si corresponde renovar, aislar o retirar el componente.

Un benchmark es un punto de partida, no la decisión final

El Control 4 de CIS plantea establecer y mantener configuraciones seguras para activos y software. Los benchmarks reconocidos ayudan a iniciar la conversación con parámetros concretos, pero deben ajustarse a la versión, función y dependencias del entorno. Aplicarlos sin pruebas puede afectar servicios; diluirlos hasta que todo cumpla elimina su propósito.

La adaptación debe conservar la trazabilidad: qué recomendación se adoptó, cuál se modificó y por qué. Así, una actualización del benchmark o de la plataforma no obliga a comenzar desde cero y permite identificar decisiones que necesitan reevaluación.

Qué debería demostrar una revisión independiente

Una revisión útil no se limita a confirmar que existe un documento. Debe tomar una muestra de activos y relacionar la línea base aplicable, el estado observado, los cambios aprobados y las excepciones vigentes. También debe comprobar que la referencia sigue alineada con el riesgo y que los desvíos generan decisiones verificables.

El NIST Cybersecurity Framework 2.0 permite ubicar esta práctica dentro del gobierno y la gestión continua del riesgo. La política de seguridad respaldada por evidencia define el criterio; la configuración segura muestra cómo se materializa en activos concretos.

Una auditoría de seguridad puede evaluar una muestra priorizada, separar fallas de gobierno de problemas técnicos y proponer una hoja de ruta. El resultado esperado no es una fotografía perfecta, sino la capacidad de reconocer cuándo una configuración cambia, decidir si el cambio es aceptable y corregirlo antes de que pierda dueño.

Equipo de negocio, TI y seguridad revisa aplicaciones SaaS utilizadas en la empresa

Shadow IT: cómo gobernar las aplicaciones SaaS que ya usa la empresa

El Shadow IT rara vez comienza con una intención de saltarse las reglas. Aparece cuando un área necesita compartir archivos, automatizar una tarea o atender clientes y encuentra una aplicación SaaS antes de que exista una respuesta corporativa. El problema no es solo que la herramienta haya sido contratada sin pasar por TI. El riesgo crece cuando nadie puede explicar qué datos contiene, quién administra sus accesos, con qué sistemas se integra o cómo se abandonará el servicio.

Bloquear todas las iniciativas puede empujar el uso fuera de la vista. Aprobarlas sin condiciones traslada decisiones críticas a una tarjeta de crédito. Una gestión útil del Shadow IT busca descubrir, asignar responsables y decidir qué aplicaciones regularizar, reemplazar o retirar según su valor y su exposición.

Shadow IT: descubrir sin convertirlo en una cacería

La primera conversación debería explicar para qué se usa cada servicio y qué necesidad resuelve. Si el levantamiento se presenta como una búsqueda de culpables, las áreas ocultarán las herramientas que más necesitan. En cambio, una revisión breve con negocio, TI, seguridad y compras permite identificar plataformas contratadas directamente, versiones gratuitas, extensiones de navegador e integraciones creadas por usuarios.

El Control 2 de CIS recomienda administrar activamente el software para que solo las soluciones autorizadas sean instaladas y ejecutadas. En servicios SaaS, “inventario” no puede limitarse a una lista de nombres: debe mostrar suficiente contexto para tomar una decisión.

Un inventario que permita tomar decisiones

Por cada aplicación conviene registrar propósito, área usuaria, responsable de negocio, administrador, modalidad de autenticación, datos tratados, integraciones, criticidad, costo y fecha de renovación. También importa saber si existe un método de exportación y quién ejecutaría el cierre. Una herramienta barata puede resultar costosa si concentra información sensible o si retirar su integración detiene un proceso comercial.

La guía del NCSC para utilizar SaaS de forma segura propone comprender la finalidad del servicio, sus opciones de autenticación y administración, el manejo de permisos, los datos involucrados y la forma de compartirlos. Estas preguntas convierten un inventario estático en una vista operativa.

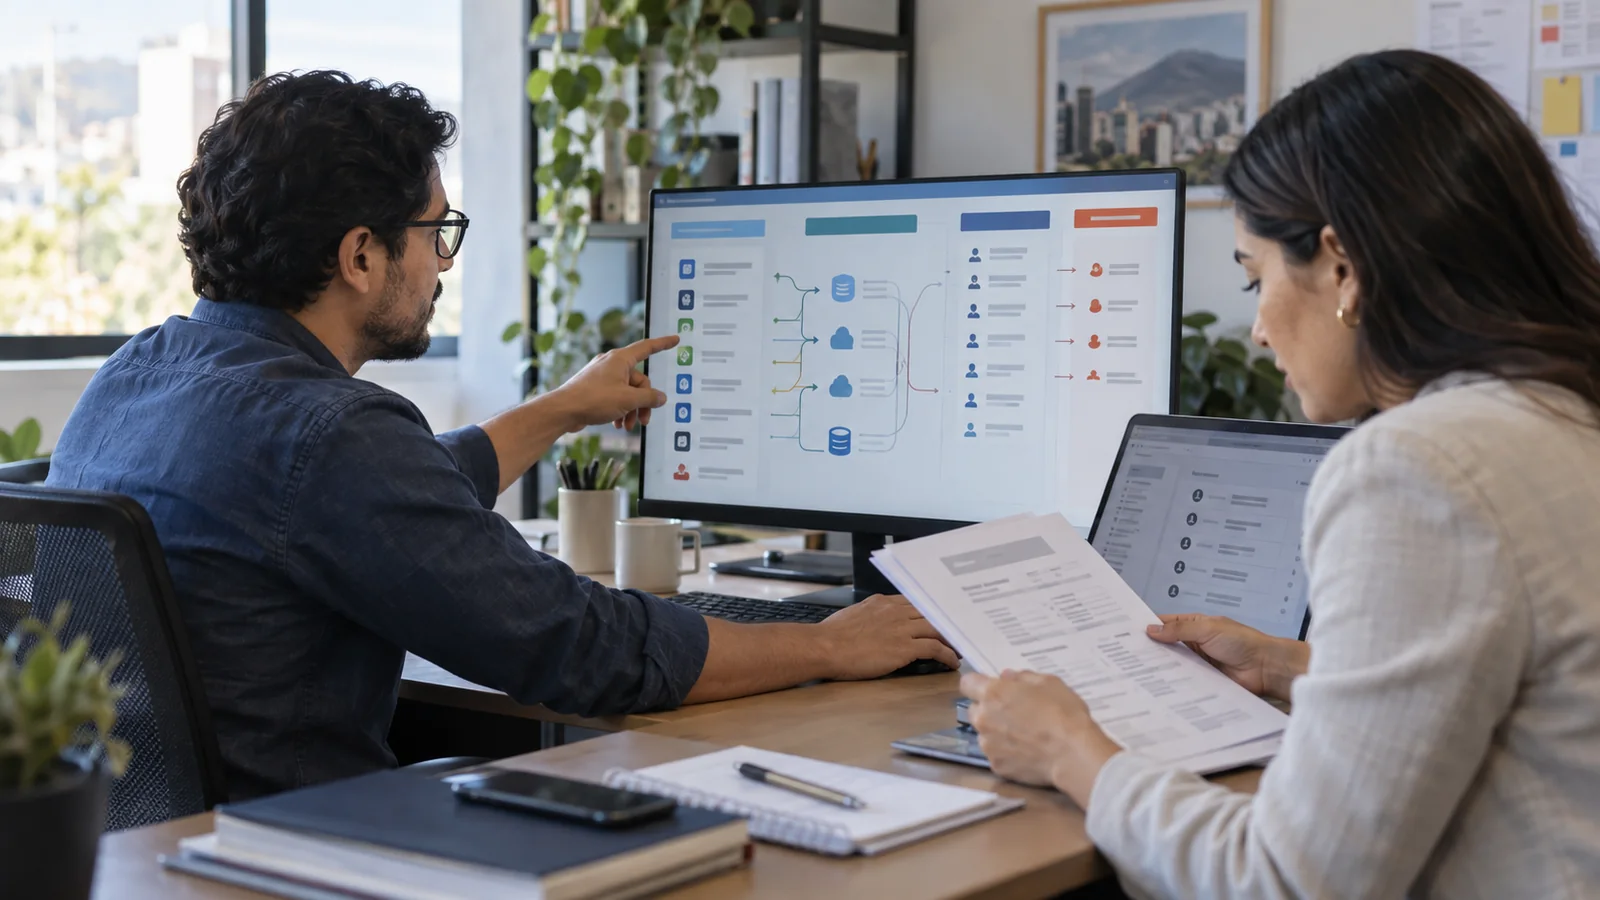
Equipo revisa aplicaciones SaaS, identidades e integraciones en un inventario visual
Relacionar aplicaciones, datos, identidades e integraciones permite priorizar decisiones. Ilustración editorial generada con IA.

Regularizar, reemplazar o retirar

No toda aplicación descubierta merece el mismo tratamiento. Una herramienta sin datos sensibles ni integraciones críticas puede regularizarse con un dueño y una configuración básica. Otra que duplica una capacidad corporativa podría migrarse. Un servicio sin soporte, sin exportación o con controles insuficientes puede requerir retiro, pero solo después de identificar dependencias y conservar la información necesaria.

La decisión debería combinar valor de negocio, sensibilidad de los datos, privilegios concedidos, alcance de las integraciones, continuidad y capacidad del proveedor. El NIST Cybersecurity Framework 2.0 ayuda a ubicar estas decisiones dentro del gobierno del riesgo, en vez de tratarlas como excepciones técnicas aisladas.

La identidad y los datos muestran el costo real

Dos aplicaciones aparentemente similares pueden tener riesgos distintos. Una usa inicio de sesión corporativo, permite revocar usuarios y almacena información pública; la otra conserva contraseñas propias, tiene administradores compartidos y recibe bases de clientes. El mapa de datos personales permite saber qué información entra y sale, mientras la gestión de accesos privilegiados aclara quién puede cambiar configuraciones o extraer contenido.

Integrar el servicio con el proveedor de identidad reduce cuentas olvidadas y facilita el retiro cuando una persona cambia de cargo. Sin embargo, el inicio de sesión único no corrige permisos excesivos dentro de la aplicación. El dueño del servicio debe revisar roles, invitados, enlaces públicos y aplicaciones conectadas con una periodicidad acorde con su criticidad.

El contrato no reemplaza la operación

El Control 15 de CIS plantea inventariar, clasificar, evaluar y supervisar proveedores. Para un SaaS, eso incluye acordar notificación de incidentes, ubicación y devolución de datos, subcontratación, continuidad, niveles de servicio y término de la relación. La cláusula sirve solo si la empresa sabe quién la activará y conserva evidencia de que los controles operan.

También debe definirse una salida antes de depender del servicio. ¿Los datos pueden exportarse en un formato utilizable? ¿Quién revoca integraciones y claves? ¿Cómo se comprueba la eliminación? ¿Cuánto tiempo necesita el proceso? Estas respuestas evitan que la renovación automática sea la única estrategia de continuidad.

Cómo recuperar control sin centralizar cada decisión

Una ruta rápida y conocida reduce el incentivo a contratar por fuera. Las aplicaciones de bajo riesgo pueden seguir un conjunto simple de requisitos; las que procesan datos sensibles, conceden acceso amplio o sostienen procesos críticos necesitan revisión adicional. Los umbrales deben ser comprensibles para negocio y no depender de interpretar una política extensa.

Los logs de seguridad aportan trazabilidad cuando responden preguntas concretas sobre accesos, cambios e integraciones. No todos los servicios ofrecerán el mismo nivel de registro, por lo que esa limitación debe influir en la clasificación y en los controles compensatorios.

El resultado esperado no es una lista perfecta, sino un proceso que detecta nuevas aplicaciones, decide con criterios consistentes y revisa lo que cambia. Una auditoría de seguridad puede tomar una muestra de servicios, reconstruir su alta y salida, y convertir las brechas encontradas en una hoja de ruta. Así, la empresa conserva la velocidad que dio origen al SaaS sin renunciar a la responsabilidad sobre sus datos y operaciones.

Ilustración referencial de un equipo de respuesta revisando la continuidad de una operación de retail; no muestra a Forus

Forus confirmó un incidente; LockBit 5 aparece en el registro

Forus informó oficialmente un incidente de ciberseguridad que afectó algunos de sus sistemas y que la compañía conoció el 15 de septiembre de 2026. Por separado, ransomware.live incorporó el dominio forus.cl bajo el nombre LockBit 5 el 18 de septiembre, a las 21:48 UTC. El primer antecedente confirma un incidente; el segundo registra una reivindicación, pero no demuestra por sí solo quién lo causó.

Qué confirmó Forus sobre el incidente

En un hecho esencial enviado a la Comisión para el Mercado Financiero el 16 de septiembre, Forus S.A. señaló que había activado sus planes de prevención, detección y respuesta junto con especialistas en ciberseguridad y análisis forense digital. A esa fecha declaró el incidente contenido, con sus tiendas funcionando normalmente y otros canales de venta en recuperación, aunque con algunas intermitencias.

La compañía también indicó que, según la información disponible al emitir el comunicado, no existían datos personales afectados de clientes, trabajadores ni terceros. Agregó que todavía no podía proyectar efectos financieros. Esas afirmaciones corresponden al estado informado el 16 de septiembre y no reemplazan una evaluación técnica posterior.

El vínculo con Chile es directo: Forus es una empresa chilena de calzado, vestuario y accesorios con tiendas, comercio electrónico y presencia regional. La continuidad de canales digitales, medios de pago, inventario y logística hace que un incidente en este sector resulte relevante para otras compañías que combinan operación física y venta en línea.

Ilustración referencial de dos especialistas revisando la recuperación de sistemas; no muestra a Forus
Ilustración editorial generada con IA, de carácter referencial. No muestra a la organización ni el incidente real.

LockBit 5: qué afirma el registro y qué falta por probar

La ficha de ransomware.live atribuye la reivindicación a “Lockbit5” y usa el dominio forus.cl. No se encontró en el comunicado de Forus una atribución al grupo, una descripción del vector de entrada, evidencia de cifrado ni confirmación de exfiltración. Tampoco se verificó una fecha pública distinta para la publicación original de la reivindicación; por eso se informa la fecha de detección del rastreador y no se presenta el 18 de septiembre como fecha del ataque.

A la fecha de esta revisión, los catálogos oficiales de grupos y software de MITRE ATT&CK no ofrecen un perfil G o S verificable para LockBit 5. El nombre tampoco autoriza a asumir que una versión reciente, sus operadores, sus afiliados y el malware sean una misma entidad.

Como contexto histórico, el Departamento de Justicia de Estados Unidos describió a LockBit como un esquema de ransomware como servicio: administradores desarrollaban herramientas y mantenían infraestructura, mientras afiliados conseguían acceso y ejecutaban ataques. Una alerta conjunta de CISA sobre LockBit 3.0 documentó conductas de una versión previa. Estas fuentes ayudan a entender antecedentes del ecosistema, pero no prueban que LockBit 5 sea idéntico ni que esas conductas hayan ocurrido en Forus.

Comportamientos históricos mapeables a ATT&CK

Las técnicas siguientes son un mapeo preventivo basado en antecedentes históricos de LockBit. No son técnicas observadas públicamente en este incidente:

Mitigaciones verificadas para empresas chilenas

MITRE relaciona cada técnica con mitigaciones concretas. Deben priorizarse según la exposición real de la empresa y validarse mediante pruebas, no solo declararse en una política.

  • M1051 — Update Software, vinculada con T1190: mantener un inventario de servicios expuestos, aplicar correcciones con plazos según criticidad y retirar interfaces que no tengan un dueño operativo.
  • M1032 — Multi-factor Authentication, vinculada con T1078: exigir MFA resistente al phishing en correo, VPN, administración remota y servicios en la nube; las excepciones deben tener responsable y vencimiento.
  • M1053 — Data Backup, vinculada con T1486: conservar copias separadas del entorno de origen y comprobar la restauración de aplicaciones prioritarias. Los objetivos de recuperación deben quedar definidos mediante RTO y RPO medibles.

Para una operación omnicanal también conviene ensayar decisiones cuando una plataforma se vuelve intermitente: qué canal se mantiene, quién autoriza una desconexión y cómo se valida el retorno. Un simulacro de ciberseguridad permite probar esa coordinación sin esperar a una crisis real. La gestión de accesos privilegiados ayuda, además, a reducir permisos permanentes sobre servicios críticos.

La atribución técnica debe quedar abierta hasta que exista evidencia verificable. Esta noticia no reproduce datos presuntamente sustraídos y distingue el comunicado oficial, el registro de la reivindicación y el contexto histórico. Las imágenes de portada e interior son ilustraciones referenciales generadas con IA.

Equipo de TI, seguridad y gerencia revisa una matriz de accesos privilegiados

Gestión de accesos privilegiados: controlar quién puede cambiarlo todo

La gestión de accesos privilegiados no comienza al comprar una plataforma. Empieza cuando la empresa puede explicar quién tiene capacidad para cambiar configuraciones, crear usuarios, detener respaldos o acceder a información sensible, para qué necesita ese poder y durante cuánto tiempo. Una cuenta administrativa sin dueño claro puede convertir un error, una credencial robada o una relación laboral terminada en un problema de alcance mayor.

Para gerencia, TI y seguridad, la decisión relevante no es si existen administradores: siempre serán necesarios. Lo importante es evitar que los privilegios sean permanentes, compartidos o más amplios de lo que exige cada función, y conservar evidencia suficiente para revisar su uso.

Gestión de accesos privilegiados: el riesgo no es solo la contraseña

Activar autenticación multifactor protege el ingreso, pero no decide qué puede hacer la persona una vez autenticada. Tampoco resuelve una cuenta genérica utilizada por varios técnicos ni elimina permisos que sobrevivieron a un cambio de cargo. Por eso, la gestión de accesos privilegiados complementa la autenticación: gobierna el alcance, la duración y la responsabilidad asociada a cada permiso crítico.

El término incluye más que la cuenta “administrador”. Abarca roles elevados en servicios de nube, consolas de respaldo, directorios, hipervisores, equipos de red, bases de datos y aplicaciones de negocio. También incluye cuentas de servicio que ejecutan procesos sin intervención humana. Su criticidad depende de lo que permiten cambiar o extraer, no del cargo de quien las utiliza.

Qué debería poder demostrar la empresa

Un inventario útil relaciona cada acceso con una identidad, un responsable, un propósito, los activos alcanzados y una fecha de revisión. Si se trata de una cuenta técnica, además debe identificar el proceso que depende de ella y quién autoriza sus cambios. Así es posible distinguir una necesidad operativa de un permiso heredado que nadie se atreve a retirar.

La identidad administrativa debería estar separada de la cuenta de uso cotidiano. Leer correo o navegar con privilegios elevados amplía innecesariamente la exposición. Las cuentas de emergencia también requieren un dueño, condiciones de activación, custodia y revisión posterior; llamar “break glass” a una contraseña compartida no la convierte en un control.

Administrador utiliza una estación dedicada mientras otra responsable valida un acceso privilegiado
Separar el uso administrativo y registrar su aprobación mejora la trazabilidad. Ilustración editorial generada con IA.

Menos privilegios permanentes, más decisiones explícitas

El NIST Cybersecurity Framework 2.0 plantea que los permisos deben administrarse y revisarse considerando mínimo privilegio y separación de funciones. El catálogo NIST SP 800-53 desarrolla estos principios en sus controles de acceso, mientras los Controles 5 y 6 de CIS separan la administración de cuentas de la asignación y revocación de privilegios.

En la práctica, esto favorece permisos aprobados cerca del momento de uso, con alcance y vencimiento definidos. No todas las empresas necesitan automatizar de inmediato el acceso justo a tiempo, pero sí deberían saber cuáles privilegios permanecen activos, por qué y hasta cuándo. Una excepción sin fecha de cierre termina convirtiéndose en la configuración normal.

También conviene separar quien solicita, quien aprueba y quien revisa, sobre todo en cambios de alto impacto. En equipos pequeños, la separación completa puede no ser viable. Allí la compensación razonable es dejar una aprobación explícita y una revisión independiente posterior, en vez de fingir que dos funciones recaídas en la misma persona son controles distintos.

La trazabilidad empieza antes del registro

Los registros pierden valor cuando varias personas usan la misma cuenta administrativa. Aunque la plataforma conserve una hora y una dirección IP, la organización no podrá atribuir la acción con precisión. Una identidad individual para cada operador, junto con el registro del permiso concedido, permite conectar la solicitud, la aprobación y la actividad realizada.

Esto no significa guardar todo indefinidamente. El artículo sobre logs de seguridad explica que primero deben definirse las preguntas que la empresa necesita responder. En accesos privilegiados, suelen ser quién obtuvo el permiso, sobre qué activo, con qué aprobación, qué acción crítica ejecutó y cuándo terminó la autorización.

Cuándo tiene sentido una solución PAM

Una plataforma de gestión de accesos privilegiados puede custodiar secretos, rotar credenciales, aprobar sesiones y registrar actividades. Su valor aumenta cuando aplica un proceso ya definido. Si las cuentas críticas siguen sin inventario, las cuentas de servicio carecen de dueño o nadie conoce las dependencias, la herramienta automatizará solo una parte del problema.

Antes de seleccionar tecnología, conviene revisar si la organización conoce sus cuentas y roles críticos, puede asociarlos a responsables, ha definido el alcance necesario y dispone de un mecanismo de emergencia. Después será posible comparar capacidades de PAM contra brechas concretas, en lugar de evaluar funciones aisladas de un catálogo.

Qué revisar primero

La prioridad debería seguir el impacto de un uso indebido. Normalmente merece atención temprana el proveedor de identidad, la consola de nube, el directorio corporativo, los respaldos, la virtualización, los equipos de red y las cuentas de servicio con alcance amplio. La segmentación de red limita recorridos técnicos; el gobierno de privilegios reduce qué acciones puede autorizar una identidad comprometida. Ambos controles responden preguntas distintas.

Una revisión inicial puede tomar una muestra de cambios recientes y reconstruir quién los solicitó, aprobó, ejecutó y verificó. Las brechas encontradas permiten ajustar la política de seguridad de la información con evidencia real. La comparación entre auditoría y análisis de vulnerabilidades ayuda a distinguir los alcances de cada revisión. El objetivo no es eliminar la administración, sino hacer que cada privilegio poderoso sea necesario, temporal y atribuible.

Si necesita contrastar los privilegios asignados con las políticas y evidencias de su empresa, conozca el servicio de auditoría de seguridad de AllDefense y defina qué controles conviene evaluar.

Taller con equipos de red y un técnico; ilustración referencial, no corresponde a S&A Chile

S&A Chile aparece en el listado atribuido a The Gentlemen

S&A Chile figura en un registro de ransomware.live atribuido a The Gentlemen, detectado el 7 de septiembre de 2026. Se trata de una reivindicación recogida por el rastreador, no de una confirmación independiente de intrusión, robo de información o impacto operativo.

S&A Chile: alcance de la reivindicación de The Gentlemen

La ficha escribe el nombre como “S A Chile” y remite a syachile.cl. El sitio oficial de S&A Chile ofrece servicios de centro de datos, nube, protección de datos y ciberseguridad, con contacto en Santiago. La coincidencia del dominio permite contextualizar la referencia sin depender de variantes tipográficas del nombre.

La mención de un integrador tecnológico requiere delimitar con cuidado cualquier afirmación sobre terceros. La ficha no acredita que servicios alojados, clientes o plataformas administradas hayan sufrido un compromiso. Tampoco permite concluir que el caso sea un incidente de cadena de suministro. Para evaluar ese riesgo se necesitarían antecedentes sobre accesos, segregación y sistemas involucrados, no solo la identidad comercial del proveedor.

La fecha usada es la de detección por ransomware.live: 7 de septiembre de 2026, a las 21:54 UTC. No se verificó una fecha separada de publicación original de la reivindicación ni la fecha efectiva de la posible intrusión. Al revisar las noticias institucionales de S&A Chile y buscar antecedentes públicos en ANCI y CSIRT de Gobierno hasta el 15 de septiembre, no se encontró una confirmación institucional específica entre las fuentes consultadas. Esta revisión no permite descartar comunicaciones privadas ni demuestra que el incidente haya ocurrido.

Ilustración referencial: dos profesionales revisan un rack de comunicaciones; no muestra a S&A Chile
Ilustración editorial generada con IA. Es referencial y no muestra a la organización ni el incidente real.

The Gentlemen: comportamiento documentado y límites

Unit 42 identifica a The Gentlemen, también Storm-2697, como un programa ransomware como servicio. Operadores, afiliados y malware cumplen funciones distintas; el listado no identifica al afiliado del caso.

No se encontró un perfil propio verificable G o S en los catálogos oficiales de grupos y software de MITRE. Las asociaciones siguientes son un mapeo analítico a ATT&CK desde investigación técnica original; no atribuyen esas conductas al caso chileno.

El informe DFIR de Check Point Research documenta uso de AnyDesk y recursos administrativos de Windows en otra intrusión, y analiza el cifrador. Ese trabajo respalda el mapeo, sin demostrar la misma secuencia aquí.

Mitigaciones verificadas en MITRE ATT&CK

Las páginas oficiales de cada técnica vinculan las mitigaciones indicadas. Su aplicación debe ajustarse al entorno y comprobarse; no garantizan por sí solas evitar un incidente.

  • M1038 — Execution Prevention: para T1219.002, permitir únicamente herramientas de soporte aprobadas mediante controles de aplicaciones.
  • M1037 — Filter Network Traffic: para T1021.002, restringir SMB mediante cortafuegos de host a las comunicaciones que realmente necesita la operación.
  • M1053 — Data Backup: para T1486, disponer de copias protegidas fuera del sistema de origen y comprobar que una aplicación prioritaria se puede restaurar.

Una prioridad práctica para el sector

Para clientes de servicios tecnológicos, una revisión útil comienza por distinguir las responsabilidades propias y las del proveedor. Conviene comprobar quién administra identidades, quién autoriza sesiones de soporte y cómo se notifica una señal relevante. Las cuentas con privilegios sobre varios ambientes merecen controles específicos y trazabilidad. Esta es una recomendación preventiva de gobierno de accesos, no una acusación de que S&A Chile haya mantenido permisos inadecuados.

La respuesta prudente es pedir evidencia y alcance por canales oficiales, revisar dependencias y evitar conclusiones sobre todos los clientes. La política de seguridad respaldada por evidencia ayuda a definir qué comprobar sin sustituir la investigación del caso.

Las imágenes de portada e interior son referenciales, generadas con IA. Las fuentes enlazadas permiten distinguir información institucional, registro de la reivindicación y análisis preventivo; no se reproducen datos sustraídos.

Ilustración referencial del sector de Tanner; no corresponde a sus instalaciones ni al incidente

Tanner figura en el registro de reivindicaciones de Qilin

Tanner figura en un registro de ransomware.live atribuido a Qilin, detectado el 4 de septiembre de 2026. Se trata de una reivindicación recogida por el rastreador, no de una confirmación independiente de intrusión, robo de información o impacto operativo.

Qué se conoce del registro y la organización

La ficha identifica a Tanner y enlaza tanner.cl. Su sitio oficial presenta servicios financieros, financiamiento automotor, seguros e inversiones en Chile. La mención de esa marca no permite atribuir una presunta afectación a todas sus sociedades o plataformas, ni asumir que un servicio específico se encuentre comprometido.

En el ámbito financiero, las preguntas relevantes incluyen integridad de instrucciones, continuidad de atención y protección de información. El registro público no responde cuáles de esos ámbitos, si alguno, fueron afectados. Tampoco confirma movimientos no autorizados, exposición de cuentas o pérdida de dinero. Asociar esos resultados a la sola aparición de un nombre sería ir más allá de la evidencia disponible.

La fecha usada es la de detección por ransomware.live. No se verificó una fecha separada de publicación original de la reivindicación ni la fecha efectiva de la posible intrusión. La revisión se realizó al 14 de septiembre de 2026: no se presenta este antecedente histórico como un ataque ocurrido hoy.

Ilustración referencial de Tanner y prevención de riesgos tecnológicos; no muestra instalaciones reales
Ilustración editorial generada con IA. Es referencial y no muestra a la organización ni el incidente real.

Qilin: comportamiento documentado y límites

MITRE ATT&CK documenta Qilin, también denominado Agenda, como software S1242. Está asociado a un modelo ransomware como servicio. El identificador corresponde al malware, no a un grupo G ni a un afiliado específico. El nombre de una reivindicación no identifica por sí solo quién habría ejecutado una intrusión.

MITRE identifica a los operadores del servicio como Water Galura, G1050, también GOLD FEATHER. Esto no identifica al afiliado del caso. Las conductas siguientes proceden del perfil del malware; no son hallazgos de esta reivindicación.

Mitigaciones verificadas en MITRE ATT&CK

Las páginas oficiales de cada técnica vinculan las mitigaciones indicadas. Su aplicación debe ajustarse al entorno y comprobarse; no garantizan por sí solas evitar un incidente.

  • M1053 — Data Backup: para T1486 y T1490, conservar copias aisladas del sistema de origen y probar la restauración en condiciones controladas.
  • M1018 — User Account Management: para T1490, restringir a las cuentas estrictamente necesarias el acceso a respaldos; revisar privilegios y revocaciones.
  • M1040 — Behavior Prevention on Endpoint: para T1486, habilitar protección de comportamiento contra ransomware en sistemas compatibles y validar su funcionamiento antes del despliegue general.

Una prioridad práctica para el sector

Una revisión preventiva para empresas financieras debe comprobar cómo se valida una instrucción sensible y qué ocurre si un sistema queda temporalmente indisponible. Es importante separar funciones de aprobación, administración y recuperación. Una restauración técnica debe acompañarse de una comprobación funcional de integridad antes de reanudar operaciones. Esta recomendación no afirma que los registros de Tanner hayan sido alterados; propone un control verificable para cualquier organización con procesos críticos.

Los clientes deben utilizar los canales oficiales para consultar información o verificar mensajes, sin asumir que una comunicación inesperada sea auténtica porque mencione este registro. La noticia recoge una reivindicación y medidas de prevención; no constituye una alerta de fraude confirmado ni una evaluación de la situación financiera de la entidad.

Las imágenes de portada e interior son referenciales, generadas con IA. Las fuentes enlazadas permiten distinguir información institucional, registro de la reivindicación y análisis preventivo; no se reproducen datos sustraídos.

Ilustración referencial del sector de Hospital Clínico Universidad de Chile; no corresponde a sus instalaciones ni al incidente

Direwolf señala al Hospital Clínico Universidad de Chile

Hospital Clínico Universidad de Chile figura en un registro de ransomware.live atribuido a Direwolf, detectado el 30 de agosto de 2026. Se trata de una reivindicación recogida por el rastreador, no de una confirmación independiente de intrusión, robo de información o impacto operativo.

Qué se conoce del registro y la organización

El registro remite a redclinica.cl. El sitio institucional identifica al Hospital Clínico Universidad de Chile, ubicado en Independencia, y presenta sus servicios asistenciales y actividades académicas. Esa referencia respalda el vínculo con Chile. No constituye evidencia de que información clínica haya sido extraída ni de que la atención haya sufrido interrupciones.

Por tratarse de una institución sanitaria, es especialmente importante no transformar una afirmación de extorsión en alarma sobre pacientes. La ficha del rastreador no permite validar categorías de datos afectados, personas involucradas ni impacto asistencial. Las cifras o descripciones que circulen atribuidas al actor necesitan confirmación independiente. Esta noticia no descarga muestras, no reproduce datos personales y no presenta como probado el contenido de la reivindicación.

La fecha usada es la de detección por ransomware.live. No se verificó una fecha separada de publicación original de la reivindicación ni la fecha efectiva de la posible intrusión. La revisión se realizó al 14 de septiembre de 2026: no se presenta este antecedente histórico como un ataque ocurrido hoy.

Ilustración referencial de Hospital Clínico Universidad de Chile y prevención de riesgos tecnológicos; no muestra instalaciones reales
Ilustración editorial generada con IA. Es referencial y no muestra a la organización ni el incidente real.

Direwolf: comportamiento documentado y límites

El actor aparece como Direwolf en ransomware.live. Halcyon describe a Dire Wolf y su ransomware homónimo, desarrollado en Go, y documenta cifrado y acciones contra recuperación. La coincidencia de denominación no permite identificar a una persona, un afiliado ni el ejecutable usado en esta reivindicación.

No se encontró un perfil propio G o S verificable en los catálogos de grupos y software de MITRE. El mapeo siguiente procede del análisis de Halcyon y de las definiciones ATT&CK. Describe comportamiento del malware, no evidencia obtenida del hospital.

Mitigaciones verificadas en MITRE ATT&CK

Las páginas oficiales de cada técnica vinculan las mitigaciones indicadas. Su aplicación debe ajustarse al entorno y comprobarse; no garantizan por sí solas evitar un incidente.

  • M1053 — Data Backup: para T1486 y T1490, conservar copias aisladas del sistema de origen y probar la restauración en condiciones controladas.
  • M1018 — User Account Management: para T1490, restringir a las cuentas estrictamente necesarias el acceso a respaldos; revisar privilegios y revocaciones.
  • M1040 — Behavior Prevention on Endpoint: para T1486, habilitar protección de comportamiento contra ransomware en sistemas compatibles y validar su funcionamiento antes del despliegue general.

Una prioridad práctica para el sector

La prioridad preventiva en salud es comprobar que la recuperación tecnológica permita retomar procesos asistenciales de manera segura. Un ejercicio puede seleccionar una aplicación, restaurarla en un entorno aislado y verificar integridad y permisos con sus responsables funcionales. La protección de respaldos debe contemplar credenciales separadas y pruebas que no expongan información de pacientes. Son medidas generales de resiliencia, no hallazgos de una investigación sobre el hospital.

Para usuarios y pacientes, la referencia válida son las comunicaciones oficiales de la institución. No conviene entregar antecedentes a terceros que prometan comprobar una supuesta exposición. Para equipos de seguridad, el seguimiento debe buscar evidencia verificable sin atribuir automáticamente al hospital las características conocidas del ransomware.

Las imágenes de portada e interior son referenciales, generadas con IA. Las fuentes enlazadas permiten distinguir información institucional, registro de la reivindicación y análisis preventivo; no se reproducen datos sustraídos.